Hana-Power-Engines Graph und Vektor
Deterministisches ERP versus stochastische KI-Agenten
Die Notwendigkeit, auf der SAP-Hana-Datenbankplattform sowohl eine Vektor-Engine als auch eine Graph-Engine parallel bereitzustellen, wurzelt in der grundlegenden architektonischen Diskrepanz zwischen stochastischer künstlicher Intelligenz und deterministischer Unternehmenssoftware.
Ein modernes ERP-System wie S/4 Hana verlangt im transaktionalen Hauptbuch nach absoluter Exaktheit, nachvollziehbarer Revisionssicherheit und festen buchhalterischen Beziehungen. Demgegenüber arbeiten große Sprachmodelle (LLMs) probabilistisch auf Basis statistischer Wahrscheinlichkeiten. Ein isolierter Einsatz generativer Sprachmodelle führt im betrieblichen Alltag zwangsläufig zu Halluzinationen, weil ein reines LLM weder das komplexe relationale Schema aus zehntausenden Tabellen noch die dynamischen Echtzeit-Zusammenhänge versteht.
Retrieval-Augmented Generation
An dieser Sollbruchstelle setzt die Hana Cloud Vector Engine an, die Vektoren nativ über Datentypen speichert und über mathematische Distanzmaße wie die Kosinus-Ähnlichkeit oder die euklidische Distanz vergleicht. Vektoren übersetzen unstrukturierte Daten, wie Rechnungsbelege, Freitexte, Produktkataloge, Support-Tickets oder Protokolle, über Embedding-Modelle in mehrdimensionale Vektorräume.
Die Vector Engine dient damit als mathematischer Ähnlichkeitsfilter für das klassische Retrieval-Augmented Generation (RAG): Bei einer Anfrage extrahiert sie semantisch verwandte Textbausteine als Top-K-Treffer in Echtzeit und übergibt diese als Grounding-Kontext an den KI-Copiloten Joule oder an Sprachmodelle.
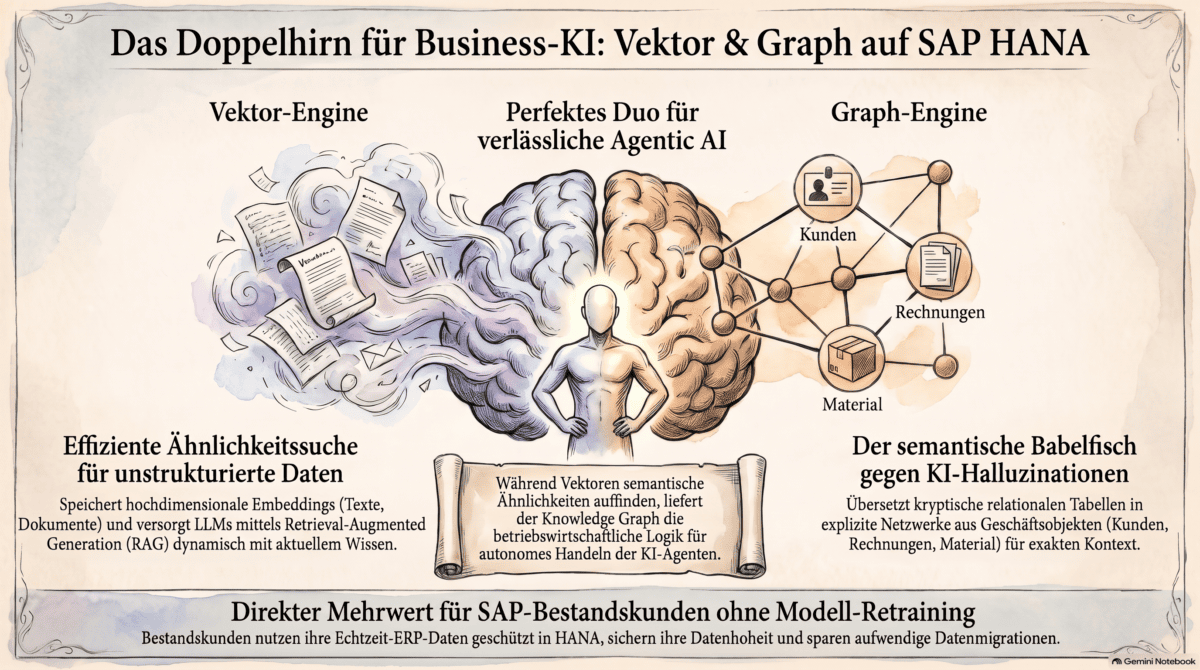
Für sich allein genommen scheitert das Vektormodell jedoch an relationalen Geschäftsregeln, weil es lediglich statistische Wort- und Textnähen abbildet, aber keine betriebswirtschaftlichen Abhängigkeiten wie die Kette von der Bestellanforderung über den Wareneingang bis zur Rechnungsprüfung auflösen kann.
SAP Knowledge Graph
Aus diesem Grund benötigt SAP zwingend die Hana Graph Engine, die auf der mathematischen Graphentheorie basiert und das technische Fundament für den SAP Knowledge Graph innerhalb der Business Data Cloud (SAP BDC) bildet. Die Graph-Engine modelliert Unternehmensdaten nicht in mehrdimensionalen Vektorräumen oder starren SQL-Tabellenzeilen, sondern als explizites Beziehungsnetzwerk aus Knoten und Kanten auf Basis von Ontologien und W3C-Standards wie RDF und SPARQL.
Der Knowledge Graph verbindet das komplexe, aus über sieben Millionen Datenfeldern bestehende relationale S/4-Datenmodell mit semantischer Prozesslogik. Er liefert den Sprachmodellen (LLMs) und autonomen KI-Agenten gewissermaßen das betriebswirtschaftliche Datenmodell (Ontologie) und den semantischen Kompass, indem er exakt definiert, was ein Kundenauftrag, ein Buchungskreis oder ein Lieferantenstamm bedeuten und wie diese Entitäten zueinander in Beziehung stehen. Erst diese expliziten Beziehungsmodelle versetzen Systeme in die Lage, logische Schlussfolgerungen über Domänengrenzen hinweg zu ziehen und fehlerhafte KI-Halluzinationen im transaktionalen Kern wirksam zu unterbinden.
GraphRAG als KI-Halluzinationen-Exit
Für den SAP-Bestandskunden entfaltet sich der tatsächliche Mehrwert aus der synergetischen Verschmelzung beider Welten im sogenannten GraphRAG. Autonome KI-Agenten, die eigenständig Arbeitsabläufe in der Beschaffung, im Supply Chain Management oder beim Finanzabschluss ausführen sollen, benötigen sowohl probabilistische Intuition als auch deterministische Leitplanken.
Während die Vector Engine es dem Agenten ermöglicht, unstrukturierte Anfragen in natürlicher Sprache aufzunehmen, relevante Dokumente semantisch zu durchsuchen und verrauschte Kundenstammdaten durch Clustering und Dubletten-Erkennung zu bereinigen, liefert die Graph-Engine den lückenlosen Ausführungskontext und die Datenhistorie (Lineage).
Muss ein Agent beispielsweise feststellen, welche Basistabelle einer bestimmten CDS-View zugrunde liegt oder welche Genehmigungsmatrix für einen kritischen Einkaufsvertrag greift, navigiert er deterministisch über die Kanten des Wissensgraphen. So entsteht eine verlässliche Entscheidungsbasis, bei der der Agent exakt im Rahmen etablierter Berechtigungen und Compliance-Vorgaben agiert.
Die Hana-Multi-Modell-Plattform
Die architektonische Stärke der Hana-Datenbankplattform liegt darin, dass sie als integrierte Multi-Modell-Plattform konzipiert ist. Anstatt für relationale Transaktionsdaten, Vektorsuchen und Wissensgraphen separate, spezialisierte Datenbanksilos (wie etwa externe Vektordatenbanken oder eigenständige Graphsysteme) betreiben und synchronisieren zu müssen, konsolidiert Hana relationale SQL-Tabellen, Graph-Objekte und Vektordaten auf einer einzigen In-Memory-Plattform. Dadurch werden hybride Abfragen möglich, bei denen relationale Unternehmensfilter (wie Buchungskreise, Mandanten oder Berechtigungen) direkt im selben SQL-Statement mit der Kosinus-Ähnlichkeit der Vector Engine kombiniert und mit Pfadanalysen der Graph-Engine verknüpft werden können. Dies eliminiert fehleranfällige ETL-Datenreplikationen, senkt Latenzzeiten und gewährleistet, dass die Sicherheits- und Berechtigungsarchitektur des ERP-Systems auf Datenbankebene gewahrt bleibt.
Mehrwert für den SAP-Bestandskunden Aus einer kritischen Perspektive darf der Bestandskunde jedoch nicht übersehen, dass SAP diese etablierten mathematischen Standardverfahren – wie die euklidische Distanz oder Graphenmatrizen – vertrieblich als exklusive Cloud-Revolution inszeniert, um Kunden in teure Subskriptionsmodelle und die Business Data Cloud zu drängen. Da die Hana Vector Engine und der Knowledge Graph vorwiegend als Cloud-Services auf der SAP BTP bereitgestellt werden, droht Anwendern eine erhebliche Kostenfalle durch verbrauchsbasierte Capacity Units und das unbarmherzige Verfallen vorausbezahlter Kreditkontingente. Erfahrene IT‑Entscheider sollten die technischen Vorteile von Vektor- und Graph-Engines daher gezielt zur Beherrschung von RAG und Agentic AI nutzen, gleichzeitig aber durch offene Schnittstellenstandards wie das Model Context Protocol (MCP) sicherstellen, dass die eigene semantische Datenarchitektur nicht in einem irreversiblen Hersteller-Lock-in endet.
 Deutsch
 English
 Español
 Français