Hana-Power-Engines : Graph et Vector
ERP déterministe contre agents d'IA stochastiques
La nécessité de déployer en parallèle un moteur vectoriel et un moteur de graphes sur la plateforme de base de données SAP HANA trouve son origine dans la divergence architecturale fondamentale entre l'intelligence artificielle stochastique et les logiciels d'entreprise déterministes.
Un système ERP moderne tel que S/4 Hana exige, dans le grand livre transactionnel, une exactitude absolue, une traçabilité garantissant la conformité aux exigences d’audit et des relations comptables fixes. À l’inverse, les grands modèles linguistiques (LLM) fonctionnent de manière probabiliste, sur la base de probabilités statistiques. Une utilisation isolée de modèles linguistiques génératifs conduit inévitablement à des « hallucinations » dans le quotidien de l’entreprise, car un LLM pur ne comprend ni le schéma relationnel complexe composé de dizaines de milliers de tables, ni les interrelations dynamiques en temps réel.
Génération augmentée par la recherche
C'est là qu'intervient le Hana Cloud Vector Engine, qui stocke les vecteurs de manière native via des types de données et les compare à l'aide de mesures de distance mathématiques telles que la similarité cosinus ou la distance euclidienne. Les vecteurs transforment les données non structurées, telles que les factures, les textes libres, les catalogues de produits, les tickets d'assistance ou les procès-verbaux, en espaces vectoriels multidimensionnels à l'aide de modèles d'embedding.
Le Vector Engine sert ainsi de filtre mathématique de similarité pour la méthode classique de « Retrieval-Augmented Generation » (RAG) : lors d’une requête, elle extrait en temps réel des extraits de texte sémantiquement apparentés sous forme de résultats « Top-K » et les transmet comme contexte d’ancrage au copilote IA Joule ou à des modèles linguistiques.
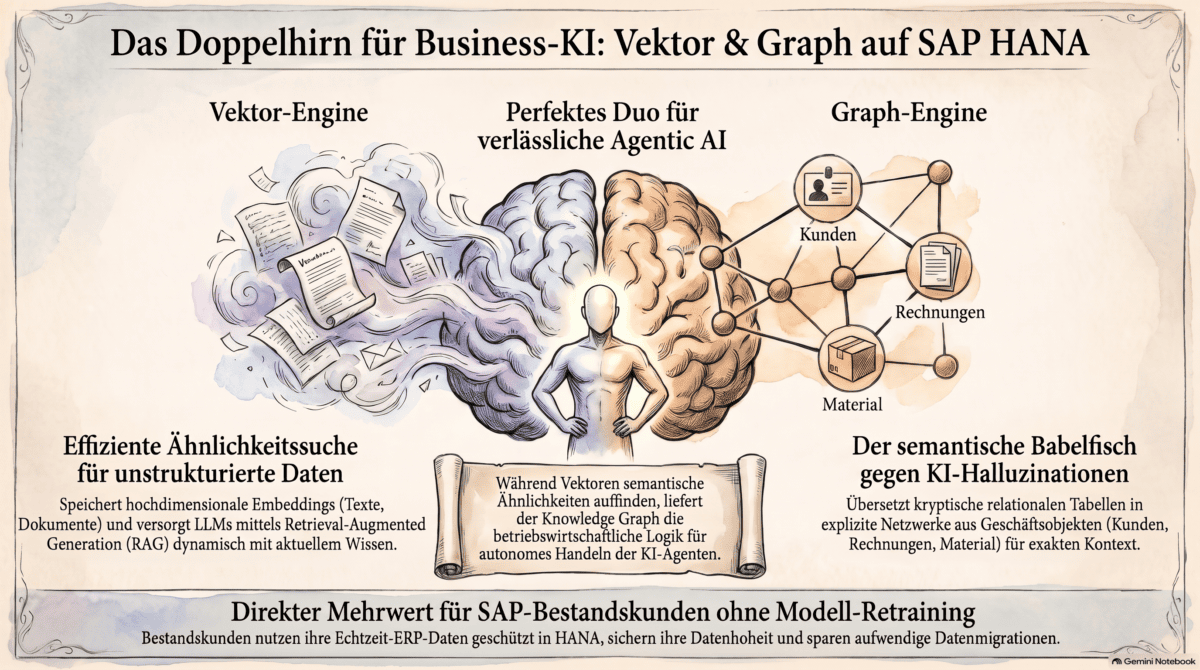
Pris isolément, le modèle vectoriel se heurte toutefois à des règles métier relationnelles, car il ne fait que refléter des proximités statistiques entre les mots et les textes, sans pouvoir résoudre les dépendances métier telles que la chaîne allant de la demande d'achat à la vérification des factures en passant par la réception des marchandises.
Graphique des connaissances SAP
C'est pourquoi SAP a impérativement besoin du moteur Hana Graph Engine, qui repose sur la théorie mathématique des graphes et constitue la base technique du SAP Knowledge Graph au sein du Business Data Cloud (SAP BDC). Le moteur de graphe ne modélise pas les données d'entreprise dans des espaces vectoriels multidimensionnels ou des lignes de tables SQL rigides, mais sous la forme d'un réseau de relations explicite composé de nœuds et d'arêtes, basé sur des ontologies et des normes W3C telles que RDF et SPARQL.
Le Knowledge Graph relie le modèle de données relationnel S/4, complexe et composé de plus de sept millions de champs de données, à une logique de processus sémantique. Il fournit en quelque sorte aux modèles linguistiques (LLM) et aux agents IA autonomes le modèle de données de gestion d’entreprise (ontologie) et la boussole sémantique, en définissant précisément ce que signifient une commande client, une société ou une fiche fournisseur, et comment ces entités sont liées entre elles. Ce sont ces modèles relationnels explicites qui permettent aux systèmes de tirer des conclusions logiques au-delà des limites des domaines et d’empêcher efficacement les « hallucinations » erronées de l’IA au cœur même du système transactionnel.
GraphRAG : une solution pour mettre fin aux hallucinations de l'IA
Pour les clients SAP existants, la véritable valeur ajoutée réside dans la fusion synergique de ces deux univers au sein de ce que l'on appelle GraphRAG. Les agents IA autonomes, chargés d'exécuter de manière autonome des processus dans les domaines des achats, de la gestion de la chaîne d'approvisionnement ou de la clôture financière, ont besoin à la fois d'une intuition probabiliste et de lignes directrices déterministes.
Alors que le moteur Vector permet à l'agent de traiter des requêtes non structurées en langage naturel, d'effectuer une recherche sémantique dans les documents pertinents et de nettoyer les données clients erronées grâce au clustering et à la détection des doublons, le moteur Graph fournit le contexte d'exécution complet et l'historique des données (lineage).
Si, par exemple, un agent doit déterminer quelle table de base sous-tend une vue CDS donnée ou quelle matrice d'autorisation s'applique à un contrat d'achat critique, il navigue de manière déterministe le long des arêtes du graphe de connaissances. Il en résulte une base décisionnelle fiable, dans laquelle l’agent agit strictement dans le cadre des autorisations établies et des exigences de conformité.
La plateforme multi-modèles Hana
La force architecturale de la plateforme de base de données HANA réside dans le fait qu’elle est conçue comme une plateforme multimodèle intégrée. Au lieu de devoir gérer et synchroniser, pour les données transactionnelles relationnelles, des recherches vectorielles et des graphes de connaissances, HANA consolide les tables SQL relationnelles, les objets de graphe et les données vectorielles sur une seule et même plateforme en mémoire. Cela permet d’effectuer des requêtes hybrides dans lesquelles des filtres relationnels d’entreprise (tels que les sociétés, les mandants ou les autorisations) peuvent être combinés directement dans la même instruction SQL avec la similarité cosinus du moteur vectoriel et associés à des analyses de chemins du moteur de graphe. Cela élimine les réplications de données ETL sources d’erreurs, réduit les temps de latence et garantit le maintien de l’architecture de sécurité et d’autorisation du système ERP au niveau de la base de données.
Valeur ajoutée pour les clients SAP existants D’un point de vue critique, le client existant ne doit toutefois pas oublier que SAP présente ces méthodes mathématiques standard bien établies – telles que la distance euclidienne ou les matrices de graphes – sont présentées, à des fins commerciales, comme une révolution exclusive du cloud, afin de pousser les clients vers des modèles d’abonnement coûteux et vers le Business Data Cloud. Étant donné que le Hana Vector Engine et le Knowledge Graph sont principalement fournis sous forme de services cloud sur la plateforme SAP BTP, les utilisateurs risquent de se retrouver face à un piège financier considérable en raison des « Capacity Units » facturées à l’utilisation et de l’expiration impitoyable des crédits prépayés. Les décideurs informatiques expérimentés devraient donc exploiter de manière ciblée les avantages techniques des moteurs vectoriels et graphiques pour maîtriser le RAG et l’Agentic AI, tout en veillant, grâce à des normes d’interfaces ouvertes telles que le Model Context Protocol (MCP), à ce que leur propre architecture de données sémantique ne débouche pas sur une dépendance irréversible vis-à-vis d’un fournisseur.
 Deutsch
 English
 Español
 Français