Green Abap für die SAP-Welt
Jedes digitale System benötigt im Betrieb Energie. Hardware wird zwar kontinuierlich effizienter, aber ineffiziente Software zwingt Server trotzdem zu unnötigen Höchstleistungen. Große Unternehmen steuern ihre Geschäftsprozesse meist mit komplexen SAP-Systemen. Die Programmiersprache Abap bildet das Herzstück dieser Anwendungen. Früher schrieben Entwicklerinnen und Entwickler Abap-Code oft nur mit Blick auf die reine Funktion. In der heutigen Zeit lohnt es sich, auch auf den Energieverbrauch zu achten. Denn schlechter Code treibt den Stromverbrauch künstlich in die Höhe.
Green Abap und Clean Code
Hier setzt der Ansatz „Green Abap“ an. Diese Methode verknüpft Nachhaltigkeitsziele direkt mit der Softwareentwicklung. „Clean Code“ spielt dabei eine riesige Rolle. Dieser Begriff beschreibt gut lesbaren und wartbaren Code. Sauberer Code reduziert Fehler und vereinfacht spätere Optimierungen in der Programmierung. Gut lesbarer Code verhindert technische Schulden, spart langfristig Hardware-Ressourcen und trägt zum Erreichen der Klimaziele bei.
So wurde getestet: Die Methodik
Wir haben den Energiehunger von Abap-Code in einer empirischen Analyse untersucht. Wir führten die Tests in einer standardisierten SAP-S/4-Hana-Umgebung in einem Schulungssystem durch. Der SAP Workload Monitor (ST03N) zeichnete die Leistungswerte präzise auf.
Dabei verglichen wir stets alte, ineffiziente Programme mit optimierten Versionen. Der Vergleich erfolgt anhand von vier wichtigen Werten: die CPU-Zeit, die Datenbank-Antwortzeit, die gesamte Antwortzeit und die angeforderte Datenmenge.
Jeder Test lief genau zehnmal ab, um zufällige Schwankungen in den Messwerten zu verhindern. Direkter Stromverbrauch lässt sich in einem SAP-System nicht einfach in Joule messen. Die ermittelten CPU- und Datenbank-Zeiten gelten allgemein aber als verlässliche Anzeiger für den Energiebedarf. Je weniger Rechenzeit ein Programm benötigt, desto weniger Strom verbraucht der Server. Neun typische Programmierfälle wurden untersucht, zu denen wir die Erkenntnisse und die dazugehörigen Code-Beispiele im Folgenden darstellen.
Fall 1: Datenbank-Abfragen in Schleifen vermeiden
Wir identifizierten wiederholte Datenbankabfragen als ein massives Performance-Problem. Die ineffiziente Version liest Datensätze Zeile für Zeile aus der Datenbank aus.
Ineffizienter Code:
REPORT zthesis_ineff_select_loop.

DATA: lt_flights TYPE TABLE OF sflight,
      ls_flight  TYPE sflight,
      lv_carrname TYPE scarr-carrname.

" Load all flight records
SELECT * FROM sflight INTO TABLE lt_flights.

" Inefficient: SELECT inside the loop
LOOP AT lt_flights INTO ls_flight.

  SELECT SINGLE carrname INTO lv_carrname
    FROM scarr
    WHERE carrid = ls_flight-carrid.

  WRITE: / ls_flight-carrid, ls_flight-connid, lv_carrname.

ENDLOOP.
Als Optimierung werden alle Daten vorab in den Arbeitsspeicher geladen. Das Programm nutzt danach schnelle interne Tabellen für den Datenabgleich.
Optimierter Code:
REPORT zthesis_eff_select_loop.

DATA: lt_flights TYPE TABLE OF sflight,
      lt_scarr   TYPE TABLE OF scarr,
      ls_flight  TYPE sflight,
      ls_scarr   TYPE scarr.

" Load both tables once
SELECT * FROM sflight INTO TABLE lt_flights.
SELECT * FROM scarr INTO TABLE lt_scarr.

" Efficient: in-memory lookup
LOOP AT lt_flights INTO ls_flight.

  READ TABLE lt_scarr INTO ls_scarr WITH KEY carrid = ls_flight-carrid.

  IF sy-subrc = 0.
    WRITE: / ls_flight-carrid, ls_flight-connid, ls_scarr-carrname.
  ENDIF.

ENDLOOP.
Die Datenbankzeit sank durch diese Optimierung um fast 99 Prozent.
Fall 2: Ineffiziente Löschung von Duplikaten
Wir testeten den ABAP-Befehl zum Löschen von Duplikaten. Ohne vorheriges Sortieren der Daten entfernt das System nur direkt benachbarte Duplikate.
Ineffizienter Code:
REPORT zthesis_ineff_delete_dupl.

DATA: lt_data TYPE TABLE OF sbook,
      ls_data TYPE sbook.

SELECT * FROM sbook INTO TABLE lt_data
  WHERE customid = '00001234'.

" No sorting before deleting duplicates
DELETE ADJACENT DUPLICATES FROM lt_data
  COMPARING carrid connid.

LOOP AT lt_data INTO ls_data.
  WRITE: / ls_data-carrid, ls_data-connid.
ENDLOOP.
In der optimierten Version fügten wir einen einfachen Sortierbefehl vor der Löschung ein.
Optimierter Code:
REPORT zthesis_opt_delete_dupl.

DATA: lt_data TYPE TABLE OF sbook,
      ls_data TYPE sbook.

SELECT * FROM sbook INTO TABLE lt_data
  WHERE customid = '00001234'.

" Efficient: Sorting before deleting duplicates
SORT lt_data BY carrid connid.

DELETE ADJACENT DUPLICATES FROM lt_data
  COMPARING carrid connid.

LOOP AT lt_data INTO ls_data.
  WRITE: / ls_data-carrid, ls_data-connid.
ENDLOOP.
Diese kleine Anpassung verbesserte die Antwortzeit des Systems um fast 47 Prozent. Das System vergleicht die Einträge so viel effizienter.
Fall 3: Datenmengen radikal an der Quelle reduzieren
Wir untersuchten das Verhalten von ungefilterten Datenbankabfragen. Die ineffiziente Version lädt unbedacht die komplette Datentabelle in den Speicher.
Ineffizienter Code:
REPORT zthesis_ineff_select_where.

SELECT * FROM sflight INTO TABLE @DATA(lt_flights).

LOOP AT lt_flights INTO DATA(ls_flight).
  " process all flights, even when not needed
  WRITE: / ls_flight-carrid, ls_flight-connid.
ENDLOOP.
Wir verlagerten den Filterprozess in der Optimierung direkt auf die Datenbankebene, indem wir eine gezielte “WHERE”-Bedingung einsetzten.
Optimierter Code:
REPORT zthesis_opt_select_where.

SELECT * FROM sflight
  WHERE carrid = 'LH'
  INTO TABLE @DATA(lt_flights_filtered).

LOOP AT lt_flights_filtered INTO DATA(ls_flight).
  " process only relevant flights
  WRITE: / ls_flight-carrid, ls_flight-connid.
ENDLOOP.
Die abgerufene Datenmenge schrumpfte dadurch sofort um über 73 Prozent.
Fall 4: Tabellen clever vergleichen
Verschachtelte Schleifen verursachen bei großen Datenmengen oft exponentielle Rechenzeiten. Wir verglichen dieses Vorgehen mit effizienten Schlüsseltabellen.
Ineffizienter Code:
REPORT zthesis_ineff_nested_loop.

DATA: lt_conn    TYPE TABLE OF spfli,
      lt_flights TYPE TABLE OF sflight.

SELECT * FROM spfli INTO TABLE lt_conn.
SELECT * FROM sflight INTO TABLE lt_flights.

LOOP AT lt_conn INTO DATA(ls_conn).

  LOOP AT lt_flights INTO DATA(ls_flight).

    IF ls_conn-carrid = ls_flight-carrid AND
       ls_conn-connid = ls_flight-connid.

      WRITE: / ls_conn-carrid, ls_conn-connid, ls_flight-fldate.

    ENDIF.

  ENDLOOP.

ENDLOOP.
Wir wandelten die zweite Tabelle für die Optimierung in eine “Hashed Table” um, so dass das Programm passende Einträge ohne große Suchvorgänge findet.
Optimierter Code:
REPORT zthesis_opt_hashed_lookup.

TYPES: BEGIN OF ty_flight_map,
         carrid TYPE sflight-carrid,
         connid TYPE sflight-connid,
         fldate TYPE sflight-fldate,
       END OF ty_flight_map.

DATA: lt_conn       TYPE TABLE OF spfli,
      lt_flight_map TYPE HASHED TABLE OF ty_flight_map
                    WITH UNIQUE KEY carrid connid.

SELECT * FROM spfli INTO TABLE lt_conn.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights_small).

LOOP AT lt_flights_small INTO DATA(ls_flight).
  INSERT ls_flight INTO TABLE lt_flight_map.
ENDLOOP.

LOOP AT lt_conn INTO DATA(ls_conn).

  READ TABLE lt_flight_map INTO DATA(ls_match)
    WITH KEY carrid = ls_conn-carrid
             connid = ls_conn-connid.

  IF sy-subrc = 0.
    WRITE: / ls_conn-carrid, ls_conn-connid, ls_match-fldate.
  ENDIF.

ENDLOOP.
Die CPU-Zeit konnte so um über 71 Prozent reduziert werden.
Fall 5: Modularisierung von Logik
Wir prüften die Auswirkungen von gut strukturiertem Code im Detail. Eine direkt im Programm ausgeführte Logik läuft linear ab.
Ineffizienter Code (Inline):
REPORT zthesis_no_function.

DATA: lv_sum TYPE i VALUE 0,
      lv_i   TYPE i.

" Calculate the sum of the first 10,000 numbers
DO 10000 TIMES.
  lv_sum = lv_sum + sy-index.
ENDDO.

WRITE: / 'Sum of first 10,000 numbers:', lv_sum.
Wir lagerten diese Rechenlogik anschließend in einen eigenen Funktionsbaustein aus. Das erzeugt minimale Strukturkosten im System.
Optimierter Code:
REPORT zthesis_with_function.

DATA: lv_result TYPE i.

CALL FUNCTION 'ZTHESIS_CALC_SUM'
  EXPORTING
    p_limit = 10000
  IMPORTING
    p_sum   = lv_result.

WRITE: / 'Sum of first 10,000 numbers (Function Module):', lv_result.
Der zugehörige Funktionsbaustein:
FUNCTION zthesis_calc_sum.

  DATA lv_index TYPE i.

  p_sum = 0.

  DO p_limit TIMES.
    lv_index = sy-index.
    p_sum = p_sum + lv_index.
  ENDDO.

ENDFUNCTION.
Die modulare Version lieferte praktisch identische Leistungswerte. Der große Gewinn liegt hier in der besseren Wartbarkeit für künftige Anpassungen.
Fall 6: Prozedural vs. Objektorientiert
Wir stellten eine einfache Zählschleife einem objektorientierten, rekursiven Ansatz gegenüber, um den Ressourcenaufwand für die Objektorientierung zu messen.
Iterativer Code:
REPORT zthesis_factorial_iterative.

START-OF-SELECTION.

DATA: lv_number TYPE i VALUE 10,
      lv_result TYPE i VALUE 1.

DO lv_number TIMES.
  lv_result = lv_result * sy-index.
ENDDO.

WRITE: / 'Iterative factorial (loop) of', lv_number, ':', lv_result.
Objektorientierter Code:
REPORT zthesis_factorial_oop.

CLASS lcl_factorial DEFINITION.

  PUBLIC SECTION.

    METHODS: calculate
      IMPORTING iv_number TYPE i
      RETURNING VALUE(rv_result) TYPE i.

ENDCLASS.

CLASS lcl_factorial IMPLEMENTATION.

  METHOD calculate.

    IF iv_number <= 1.
      rv_result = 1.
    ELSE.
      rv_result = iv_number * calculate( iv_number - 1 ).
    ENDIF.

  ENDMETHOD.

ENDCLASS.

START-OF-SELECTION.

DATA(lo_factorial) = NEW lcl_factorial( ).

DATA(lv_result) = lo_factorial->calculate( 10 ).

WRITE: / 'Recursive factorial (OOP) of 10:', lv_result.
Die objektorientierte Variante verbrauchte rund 22 Prozent mehr CPU-Zeit und lohnt sich bei solch simplen Operationen energetisch nicht. Bei großen Architekturen überwiegt langfristig aber der Vorteil der Skalierbarkeit.
Fall 7: Vermeidung von “SELECT “
Viele Entwicklerinnen und Entwickler nutzen aus Bequemlichkeit den Datenbankbefehl “SELECT *”. Das System lädt dabei blind sämtliche Spalten einer Tabelle.
Ineffizienter Code:
REPORT zthesis_ineff_select_star.

SELECT * FROM sflight
  INTO TABLE @DATA(lt_flights).

LOOP AT lt_flights INTO DATA(ls_flight).
  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.
ENDLOOP.
Wir passten den Code an und fragten nur noch exakt die drei benötigten Spalten explizit ab.
Optimierter Code:
REPORT zthesis_opt_select_fields.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights_reduced).

LOOP AT lt_flights_reduced INTO DATA(ls_flight).
  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.
ENDLOOP.
Diese minimale Reduzierung sparte über 73 Prozent des abgerufenen Datenvolumens ein.
Fall 8: Übersichtlicher Kontrollfluss
Sauberer Code benötigt einen klaren und vorhersehbaren Ablauf. Wir analysierten eine Schleife mit vielen verteilten Abbruchbedingungen.
Ineffizienter Code:
REPORT zthesis_ineff_control_flow.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lv_found) = abap_false.

LOOP AT lt_flights INTO DATA(ls_flight).

  IF ls_flight-carrid IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-connid IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-fldate IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-carrid = 'XX'.
    CONTINUE.
  ELSEIF ls_flight-carrid = 'YY'.
    CONTINUE.
  ENDIF.

  IF ls_flight-connid = '9999'.
    lv_found = abap_true.
    EXIT.
  ENDIF.

  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.

ENDLOOP.

IF lv_found = abap_true.
  WRITE: / 'Special connection found.'.
ENDIF.
Als Optimierung fassten wir die vielen Sprünge in einer einzigen, sauberen Kontrollabfrage zusammen.
Optimierter Code:
REPORT zthesis_opt_control_flow.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lv_found) = abap_false.

LOOP AT lt_flights INTO DATA(ls_flight).

  IF ls_flight-carrid IS INITIAL
     OR ls_flight-connid IS INITIAL
     OR ls_flight-fldate IS INITIAL
     OR ls_flight-carrid = 'XX'
     OR ls_flight-carrid = 'YY'.

    CONTINUE.

  ENDIF.

  IF ls_flight-connid = '9999'.
    lv_found = abap_true.
    EXIT.
  ENDIF.

  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.

ENDLOOP.

IF lv_found = abap_true.
  WRITE: / 'Special connection found.'.
ENDIF.
Die Laufzeit veränderte sich durch diese Maßnahme kaum. Der Code ist nun aber wesentlich lesbarer und leichter zu verstehen.
Fall 9: Unnötige Speicherbelegung reduzieren
Manche Programme kopieren große Datentabellen mehrfach im Arbeitsspeicher. Sie bauen zudem riesige Textpuffer auf.
Ineffizienter Code:
REPORT zthesis_ineff_memory.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lt_copy1) = lt_flights.
DATA(lt_copy2) = lt_copy1.

DATA lv_buffer TYPE string.

LOOP AT lt_copy2 INTO DATA(ls_flight).

  CONCATENATE lv_buffer
              ls_flight-carrid
              ls_flight-connid
              ls_flight-fldate
    INTO lv_buffer
    SEPARATED BY space.

ENDLOOP.

WRITE: / lines( lt_copy2 ).
Wir verarbeiteten die Originaldaten in der optimierten Version direkt und verzichteten auf unnötige Zwischenkopien.
Optimierter Code:
REPORT zthesis_opt_memory.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA lv_count TYPE i.

lv_count = 0.

LOOP AT lt_flights INTO DATA(ls_flight).
  lv_count = lv_count + 1.
ENDLOOP.

WRITE: / lv_count.
Die CPU-Zeit fiel durch diesen direkten Zugriff um über 33 Prozent.
Übersicht über die Einsparungen
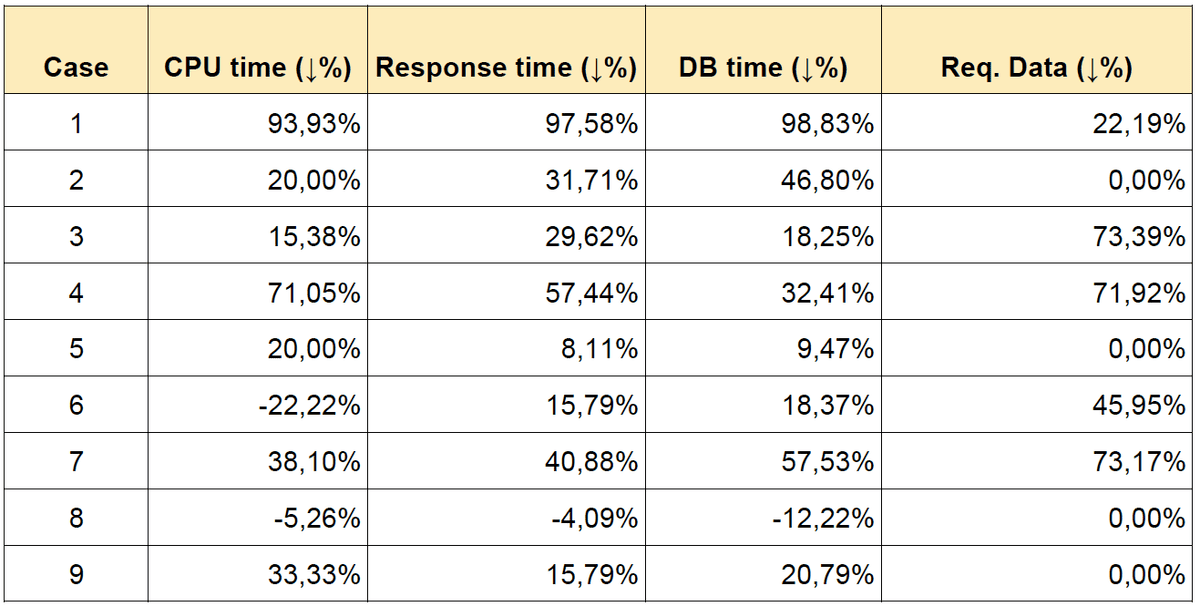
Die Ergebnisse der Optimierungsexperimente sind teilweise deutlich. Der Verzicht auf Datenbankabfragen in Schleifen senkte die Datenbankzeit um nahezu 99 Prozent. Die CPU-Zeit fiel bei diesem speziellen Test um fast 94 Prozent.
Das Filtern per „WHERE“-Bedingung reduzierte die abgerufene Datenmenge am Server um über 73 Prozent. Auch der Verzicht auf das bequeme „SELECT *“ sparte mehr als 73 Prozent der angeforderten Daten ein. Clevere Hashed Tables senkten die CPU-Last beim Vergleichen von Tabellen um beachtliche 71 Prozent.
Über alle neun untersuchten Fälle hinweg reduzierte sich die CPU-Zeit meistens um beachtliche 20 bis 90 Prozent. Die Datenbankzeiten schrumpften ebenfalls massiv um 30 bis fast 99 Prozent. Eine vollständige Übersicht zeigt Tabelle 1.
Fazit
Green Abap ist noch wenig beachtet, aber es ist eine handfeste Strategie für eine weitaus bessere Softwarearchitektur. Optimierter Code senkt den Stromverbrauch eines Systems drastisch. Er entlastet die Hardware, senkt im Unternehmen Energiekosten und ist gut für die Umwelt. Entwicklerteams müssen die eine oder andere alte Gewohnheit ablegen. Datenbankabfragen gehören strikt gebündelt und übertragene Datenmengen müssen gezielt klein gehalten werden. Tools wie der SAP Code Inspector helfen bei der systematischen Umsetzung.
Seit Einführung der Hana-Datenbanktechnologie propagiert SAP ohnehin den Code-Pushdown, also das systematische Auslagern von Rechenaufgaben in die Datenbankebene. Nachhaltiges Programmieren verbindet technische Exzellenz mit wichtigem Klimaschutz. Jeder optimierte Codeblock leistet so einen spürbaren Beitrag zu einer grüneren Informationstechnologie.
 Deutsch
 English
 Español
 Français