Green Abap para el mundo SAP
Todo sistema digital necesita energía para funcionar. Aunque el hardware es cada vez más eficiente, el software ineficiente sigue obligando a los servidores a alcanzar niveles de rendimiento máximos innecesarios. Las grandes empresas suelen gestionar sus procesos de negocio con complejos sistemas SAP. El lenguaje de programación ABAP constituye el núcleo de estas aplicaciones. Antes, los desarrolladores solían escribir código ABAP centrándose únicamente en la funcionalidad. Hoy en día, merece la pena prestar atención también al consumo energético. Y es que un código deficiente aumenta artificialmente el consumo de electricidad.
Green ABAP y Clean Code
Aquí es donde entra en juego el enfoque „Green ABAP“. Este método vincula directamente los objetivos de sostenibilidad con el desarrollo de software. El „código limpio“ desempeña un papel fundamental en este sentido. Este término se refiere a un código fácil de leer y de mantener. El código limpio reduce los errores y simplifica las optimizaciones posteriores en la programación. Un código fácil de leer evita la deuda técnica, ahorra recursos de hardware a largo plazo y contribuye a alcanzar los objetivos climáticos.
Así se realizó la prueba: la metodología
Hemos analizado el consumo energético del código ABAP mediante un análisis empírico. Las pruebas se llevaron a cabo en un entorno SAP S/4 HANA estandarizado, dentro de un sistema de formación. El SAP Workload Monitor (ST03N) registró con precisión los valores de rendimiento.
Para ello, comparamos siempre los programas antiguos e ineficientes con versiones optimizadas. La comparación se basa en cuatro parámetros importantes: el tiempo de CPU, el tiempo de respuesta de la base de datos, el tiempo de respuesta total y el volumen de datos solicitado.
Cada prueba se realizó exactamente diez veces para evitar fluctuaciones aleatorias en los valores medidos. En un sistema SAP no es fácil medir el consumo eléctrico directo en julios. Sin embargo, los tiempos de CPU y de base de datos obtenidos se consideran, en general, indicadores fiables del consumo energético. Cuanto menos tiempo de cálculo necesite un programa, menos electricidad consumirá el servidor. Se analizaron nueve casos típicos de programación, cuyos resultados y ejemplos de código correspondientes se presentan a continuación.
Caso 1: Evitar consultas a la base de datos en bucles
Identificamos que las consultas repetidas a la base de datos suponían un grave problema de rendimiento. La versión ineficiente lee los registros de la base de datos línea por línea.
Código ineficiente:
REPORT zthesis_ineff_select_loop.

DATA: lt_flights TYPE TABLE OF sflight,
 ls_flight  TYPE sflight,
 lv_carrname TYPE scarr-carrname.

" Cargar todos los registros de vuelos
SELECT * FROM sflight INTO TABLE lt_flights.

" Ineficiente: SELECT dentro del bucle
LOOP AT lt_flights INTO ls_flight.

  SELECT SINGLE carrname INTO lv_carrname
    FROM scarr
    WHERE carrid = ls_flight-carrid.

  WRITE: / ls_flight-carrid, ls_flight-connid, lv_carrname.

ENDLOOP.
Para optimizar el proceso, todos los datos se cargan previamente en la memoria RAM. A continuación, el programa utiliza tablas internas de acceso rápido para la comparación de datos.
Código optimizado:
REPORT zthesis_eff_select_loop.

DATA: lt_flights TYPE TABLE OF sflight,
 lt_scarr   TYPE TABLE OF scarr,
 ls_flight  TYPE sflight,
 ls_scarr   TYPE scarr.

" Cargar ambas tablas una vez
SELECT * FROM sflight INTO TABLE lt_flights.
SELECT * FROM scarr INTO TABLE lt_scarr.

" Eficiente: búsqueda en memoria
LOOP AT lt_flights INTO ls_flight.

  READ TABLE lt_scarr INTO ls_scarr WITH KEY carrid = ls_flight-carrid.

  IF sy-subrc = 0.
    WRITE: / ls_flight-carrid, ls_flight-connid, ls_scarr-carrname.
  ENDIF.

ENDLOOP.
Gracias a esta optimización, el tiempo de la base de datos se redujo en casi un 99 por ciento.
Caso 2: Eliminación ineficaz de duplicados
Probamos el comando ABAP para eliminar duplicados. Si no se ordenan previamente los datos, el sistema solo elimina los duplicados que están uno al lado del otro.
Código ineficiente:
REPORT zthesis_ineff_delete_dupl.

DATA: lt_data TYPE TABLE OF sbook,
 ls_data TYPE sbook.

SELECT * FROM sbook INTO TABLE lt_data
  WHERE customid = '00001234'.

"No se ordena antes de eliminar los duplicados»
ELIMINA LOS DUPLICADOS ADYACENTES DE lt_data
  COMPARANDO carrid y connid.

LOOP AT lt_data INTO ls_data.
  WRITE: / ls_data-carrid, ls_data-connid.
ENDLOOP.
En la versión optimizada, hemos añadido una sencilla instrucción de ordenación antes de la eliminación.
Código optimizado:
REPORT zthesis_opt_delete_dupl.

DATA: lt_data TYPE TABLE OF sbook,
 ls_data TYPE sbook.

SELECT * FROM sbook INTO TABLE lt_data
  WHERE customid = '00001234'.

"Eficiente: ordenar antes de eliminar duplicados»
SORT lt_data BY carrid connid.

ELIMINAR DUPLICADOS ADYACENTES DE lt_data
  COMPARANDO carrid y connid.

BUCLE POR lt_data EN ls_data.
  ESCRIBIR: / ls_data-carrid, ls_data-connid.
FIN DEL BUCLE.
Este pequeño ajuste mejoró el tiempo de respuesta del sistema en casi un 47 %. De este modo, el sistema compara las entradas de forma mucho más eficiente.
Caso 3: Reducir drásticamente el volumen de datos en el origen
Analizamos el comportamiento de las consultas a bases de datos sin filtrar. La versión ineficiente carga sin más toda la tabla de datos en la memoria.
Código ineficiente:
REPORT zthesis_ineff_select_where.

SELECT * FROM sflight INTO TABLE @DATA(lt_flights).

LOOP AT lt_flights INTO DATA(ls_flight).
  " procesar todos los vuelos, incluso cuando no sea necesario
  WRITE: / ls_flight-carrid, ls_flight-connid.
ENDLOOP.
Para optimizar el proceso, trasladamos directamente el filtrado al nivel de la base de datos mediante el uso de una condición “WHERE” específica.
Código optimizado:
REPORT zthesis_opt_select_where.

SELECT * FROM sflight
  WHERE carrid = 'LH'
  INTO TABLE @DATA(lt_flights_filtered).

LOOP AT lt_flights_filtered INTO DATA(ls_flight).
  " procesar solo los vuelos relevantes
  WRITE: / ls_flight-carrid, ls_flight-connid.
ENDLOOP.
De este modo, el volumen de datos consultados se redujo inmediatamente en más del 73 por ciento.
Caso 4: Comparar tablas de forma inteligente
Los bucles anidados suelen provocar tiempos de cálculo exponenciales cuando se trabaja con grandes volúmenes de datos. Hemos comparado este enfoque con el uso de tablas de claves eficientes.
Código ineficiente:
REPORT zthesis_ineff_nested_loop.

DATA: lt_conn    TYPE TABLE OF spfli,
 lt_flights TYPE TABLE OF sflight.

SELECT * FROM spfli INTO TABLE lt_conn.
SELECT * FROM sflight INTO TABLE lt_flights.

LOOP AT lt_conn INTO DATA(ls_conn).

  LOOP AT lt_flights INTO DATA(ls_flight).

    IF ls_conn-carrid = ls_flight-carrid AND
 ls_conn-connid = ls_flight-connid.

 WRITE: / ls_conn-carrid, ls_conn-connid, ls_flight-fldate.

    ENDIF.

  ENDLOOP.

ENDLOOP.
Convertimos la segunda tabla en una “tabla hash” para optimizarla, de modo que el programa encuentre las entradas correspondientes sin necesidad de realizar búsquedas extensas.
Código optimizado:
REPORT zthesis_opt_hashed_lookup.

TIPOS: COMIENZO DE ty_flight_map,
 carrid TIPO sflight-carrid,
 connid TIPO sflight-connid,
 fldate TIPO sflight-fldate,
 FIN DE ty_flight_map.

DATOS: lt_conn TIPO TABLA DE spfli,
 lt_flight_map TIPO TABLA HASH DE ty_flight_map
 CON CLAVE ÚNICA carrid connid.

SELECT * FROM spfli INTO TABLA lt_conn.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights_small).

LOOP AT lt_flights_small INTO DATA(ls_flight).
  INSERT ls_flight INTO TABLE lt_flight_map.
ENDLOOP.

LOOP AT lt_conn INTO DATA(ls_conn).

  READ TABLE lt_flight_map INTO DATA(ls_match)
    WITH KEY carrid = ls_conn-carrid
             connid = ls_conn-connid.

  IF sy-subrc = 0.
    WRITE: / ls_conn-carrid, ls_conn-connid, ls_match-fldate.
  ENDIF.

ENDLOOP.
De este modo, se logró reducir el tiempo de CPU en más del 71 por ciento.
Caso 5: Modularización de la lógica
Analizamos en detalle los efectos de un código bien estructurado. Una lógica que se ejecuta directamente en el programa se desarrolla de forma lineal.
Código ineficiente (en línea):
REPORT zthesis_no_function.

DATA: lv_sum TYPE i VALUE 0,
 lv_i   TYPE i.

" Calcular la suma de los primeros 10.000 números
DO 10000 TIMES.
  lv_sum = lv_sum + sy-index.
ENDDO.

WRITE: / 'Suma de los primeros 10 000 números:', lv_sum.
A continuación, externalizamos esta lógica de cálculo a un módulo de funciones independiente. Esto genera unos costes de estructura mínimos en el sistema.
Código optimizado:
REPORT zthesis_with_function.

DATA: lv_result TYPE i.

CALL FUNCTION 'ZTHESIS_CALC_SUM'
  EXPORTANDO
    p_limit = 10000
  IMPORTANDO
    p_sum   = lv_result.

ESCRIBE: / 'Suma de los primeros 10 000 números (módulo de función):', lv_result.
El módulo de funciones correspondiente:
FUNCIÓN zthesis_calc_sum.

  DATA lv_index TYPE i.

  p_sum = 0.

  DO p_limit TIMES.
    lv_index = sy-index.
    p_sum = p_sum + lv_index.
  ENDDO.

ENDFUNCTION.
La versión modular ofreció unos valores de rendimiento prácticamente idénticos. La gran ventaja en este caso radica en la mayor facilidad de mantenimiento de cara a futuras adaptaciones.
Caso 6: Programación procedimental frente a programación orientada a objetos
Comparamos un bucle de recuento sencillo con un enfoque recursivo orientado a objetos para medir el consumo de recursos que supone la programación orientada a objetos.
Código iterativo:
REPORT zthesis_factorial_iterative.

START-OF-SELECTION.

DATA: lv_number TYPE i VALUE 10,
 lv_result TYPE i VALUE 1.

DO lv_number TIMES.
  lv_result = lv_result * sy-index.
ENDDO.

WRITE: / 'Factorial iterativo (bucle) de', lv_number, ':', lv_result.
Código orientado a objetos:
REPORT zthesis_factorial_oop.

CLASS lcl_factorial DEFINITION.

  SECCIÓN PÚBLICA.

 MÉTODOS: calculate
 IMPORTANDO iv_number TIPO i
 DEVOLVIENDO VALOR(rv_result) TIPO i.

FIN DE CLASE.

CLASE lcl_factorial IMPLEMENTACIÓN.

  MÉTODO calculate.

    IF iv_number calculate( 10 ).

WRITE: / 'Factorial recursivo (OOP) de 10:', lv_result.
La variante orientada a objetos consumió aproximadamente un 22 % más de tiempo de CPU y, en operaciones tan sencillas, no resulta rentable desde el punto de vista energético. Sin embargo, en arquitecturas de gran tamaño, a largo plazo prevalece la ventaja de la escalabilidad.
Caso 7: Cómo evitar el uso de “SELECT “
Muchos desarrolladores y desarrolladoras utilizan, por comodidad, el comando de base de datos “SELECT *”. Al hacerlo, el sistema carga sin distinción todas las columnas de una tabla.
Código ineficiente:
REPORT zthesis_ineff_select_star.

SELECT * FROM sflight
  INTO TABLE @DATA(lt_flights).

LOOP AT lt_flights INTO DATA(ls_flight).
  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.
ENDLOOP.
Adaptamos el código y pasamos a consultar explícitamente solo las tres columnas necesarias.
Código optimizado:
REPORT zthesis_opt_select_fields.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights_reduced).

LOOP AT lt_flights_reduced INTO DATA(ls_flight).
  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.
ENDLOOP.
Esta reducción mínima permitió ahorrar más del 73 % del volumen de datos consultado.
Caso 8: Flujo de control claro
Un código limpio requiere un flujo claro y predecible. Analizamos un bucle con muchas condiciones de salida repartidas.
Código ineficiente:
REPORT zthesis_ineff_control_flow.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lv_found) = abap_false.

LOOP AT lt_flights INTO DATA(ls_flight).

  IF ls_flight-carrid IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-connid IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-fldate IS INITIAL.
    CONTINUE.
  ENDIF.

  IF ls_flight-carrid = 'XX'.
    CONTINUE.
  ELSEIF ls_flight-carrid = 'YY'.
    CONTINUE.
  ENDIF.

  IF ls_flight-connid = '9999'.
    lv_found = abap_true.
    EXIT.
  ENDIF.

  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.

ENDLOOP.

IF lv_found = abap_true.
  WRITE: / 'Se ha encontrado una conexión especial.'.
ENDIF.
Para optimizar el código, agrupamos los numerosos saltos en una única consulta de control clara.
Código optimizado:
REPORT zthesis_opt_control_flow.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lv_found) = abap_false.

LOOP AT lt_flights INTO DATA(ls_flight).

  IF ls_flight-carrid IS INITIAL
 OR ls_flight-connid IS INITIAL
 OR ls_flight-fldate IS INITIAL
 OR ls_flight-carrid = 'XX'
     O ls_flight-carrid = 'YY'.

 CONTINUE.

  ENDIF.

  IF ls_flight-connid = '9999'.
    lv_found = abap_true.
    EXIT.
  ENDIF.

  WRITE: / ls_flight-carrid, ls_flight-connid, ls_flight-fldate.

ENDLOOP.

IF lv_found = abap_true.
  WRITE: / 'Se ha encontrado una conexión especial.'.
ENDIF.
El tiempo de ejecución apenas se vio afectado por esta medida. Sin embargo, ahora el código es mucho más legible y fácil de entender.
Caso 9: Reducir el uso innecesario de memoria
Algunos programas copian varias veces tablas de datos de gran tamaño en la memoria RAM. Además, crean enormes búferes de texto.
Código ineficiente:
REPORT zthesis_ineff_memory.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA(lt_copy1) = lt_flights.
DATA(lt_copy2) = lt_copy1.

DATA lv_buffer TYPE string.

LOOP AT lt_copy2 INTO DATA(ls_flight).

  CONCATENATE lv_buffer
 ls_flight-carrid
 ls_flight-connid
 ls_flight-fldate
    INTO lv_buffer
    SEPARATED BY space.

ENDLOOP.

WRITE: / lines( lt_copy2 ).
Procesamos los datos originales directamente en la versión optimizada y prescindimos de copias intermedias innecesarias.
Código optimizado:
REPORT zthesis_opt_memory.

SELECT carrid, connid, fldate
  FROM sflight
  INTO TABLE @DATA(lt_flights).

DATA lv_count TYPE i.

lv_count = 0.

LOOP AT lt_flights INTO DATA(ls_flight).
  lv_count = lv_count + 1.
ENDLOOP.

WRITE: / lv_count.
Gracias a este acceso directo, el tiempo de CPU se redujo en más del 33 por ciento.
Resumen de los ahorros
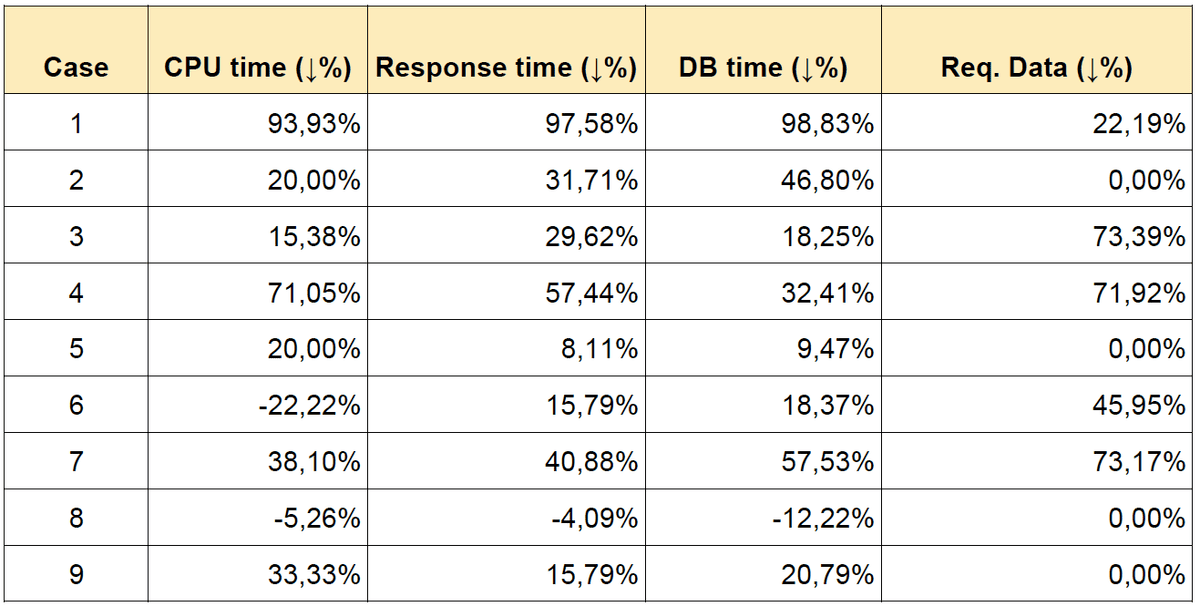
Los resultados de los experimentos de optimización son, en algunos casos, evidentes. Al evitar las consultas a la base de datos en los bucles, el tiempo de consulta a la base de datos se redujo en casi un 99 por ciento. En esta prueba concreta, el tiempo de CPU se redujo en casi un 94 por ciento.
El filtrado mediante la condición „WHERE“ redujo el volumen de datos recuperados del servidor en más del 73 por ciento. Además, prescindir del cómodo „SELECT *“ supuso un ahorro de más del 73 % de los datos solicitados. Unas ingeniosas tablas hash redujeron la carga de la CPU al comparar tablas en un notable 71 %.
En los nueve casos analizados, el tiempo de CPU se redujo en la mayoría de los casos en un notable porcentaje, que osciló entre el 20 % y el 90 %. Los tiempos de la base de datos también se redujeron de forma considerable, entre un 30 % y casi un 99 %. En la tabla 1 se muestra un resumen completo.
Conclusión:
Green ABAP aún no ha recibido mucha atención, pero es una estrategia sólida para lograr una arquitectura de software mucho mejor. Un código optimizado reduce drásticamente el consumo eléctrico de un sistema. Alivia la carga del hardware, reduce los costes energéticos de la empresa y es beneficioso para el medio ambiente. Los equipos de desarrollo deben abandonar algunos viejos hábitos. Las consultas a bases de datos deben agruparse de forma estricta y el volumen de datos transmitidos debe reducirse de forma específica. Herramientas como SAP Code Inspector ayudan a llevar a cabo esta implementación de forma sistemática.
Desde la introducción de la tecnología de bases de datos HANA, SAP ya viene promoviendo el «code pushdown», es decir, la externalización sistemática de tareas de cálculo al nivel de la base de datos. La programación sostenible combina la excelencia técnica con una importante contribución a la protección del clima. Cada bloque de código optimizado contribuye así de forma notable a una tecnología de la información más ecológica.
 Deutsch
 English
 Español
 Français