Künstliche Intelligenz ohne Cloud-Zwang: SAP und KI – Seite an Seite
Bereits seit zwei, drei Jahren treibt SAP die Integration von künstlicher Intelligenz in seine Lösungen mit Nachdruck voran, konzentriert sich dabei aber auf aktuelle S/4-Hana-Releases und die SAP-Cloud. Neukunden kann der Walldorfer Software-Konzern damit durchaus überzeugen – zumindest enthalten inzwischen laut SAP-Chef Christian Klein zwei Drittel der neuen Verträge auch KI-Komponenten. Für viele Bestandskunden ist ein Umstieg auf S/4 Hana und Cloud jedoch keine Option, denn sie besitzen komplexe, teilweise über Jahrzehnte gewachsene, lokale Umgebungen mit SAP ECC. Deren Migration wäre äußerst aufwendig und kostenintensiv und würde voraussichtlich einige Jahre dauern. Das sorgfältige Customizing der Vergangenheit ginge weitgehend verloren.
Hinzu kommt, dass mehr und mehr Unternehmen inzwischen auf Datensouveränität achten und insbesondere der Auslagerung von geschäftskritischen Daten und Systemen in die Clouds von Hyperscalern skeptisch gegenüberstehen. Sie befürchten einen Kontrollverlust und Abhängigkeiten, die sich bei Bedarf schlecht auflösen lassen, sodass etwa bei plötzlichen Kostensteigerungen, größeren funktionalen Änderungen oder Einschränkungen beim Zugang zu den Diensten ein einfacher Wechsel zu anderen Anbietern kaum möglich ist. Einer Studie von Red Hat zufolge haben beispielsweise nur 57 Prozent der deutschen Unternehmen eine definierte Exit-Strategie für ihren primären KI-Anbieter, und selbst von diesen Unternehmen gehen 37 Prozent von moderaten bis erheblichen Auswirkungen auf ihre Geschäftskontinuität aus, sollten sie einen Anbieterwechsel tatsächlich umsetzen müssen.
Trennung von SAP und KI
Unabhängig davon existieren je nach Branche auch unterschiedlich strenge regulatorische Vorgaben hinsichtlich der Datenhaltung, durch die vielen Unternehmen unter anderem aus der Finanzindustrie und dem Gesundheitswesen der Weg in die Cloud mehr oder weniger verschlossen bleibt. Beim KI-Einsatz in der SAP-Welt sind sie damit außen vor und können den Datenschatz aus ihren SAP-Systemen nicht nutzen, um neue Erkenntnisse zu gewinnen und Prozesse sowie Entscheidungen zu verbessern – jedenfalls nicht mit den von SAP bereitgestellten KI-Komponenten wie SAP Joule.
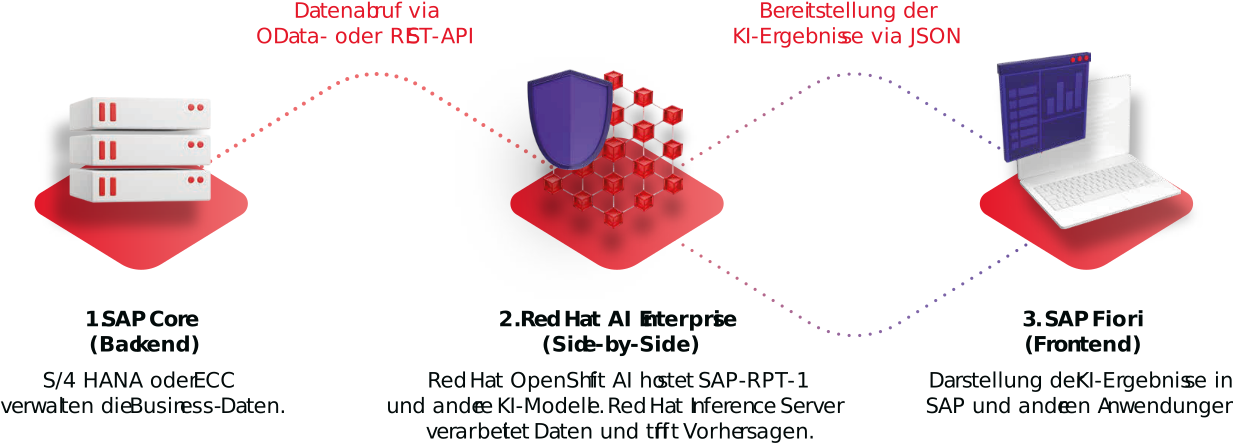
Zwar gibt es die Möglichkeit, die on-premises laufenden Bestandssysteme mit Add-ons von Drittanbietern um KI zu erweitern. Allerdings sind viele dieser Add-ons ebenfalls Cloud-basiert und gehen mit Abhängigkeiten und nicht selten erheblichen Kosten einher. Ein charmanter Ansatz, KI dennoch in das klassische SAP einzubinden, ist hingegen das Side-by-Side-Modell. Hier bleiben die KI-Systeme von den SAP-Kernsystemen getrennt und werden in einer separaten, eng angebundenen Architektur betrieben. Die bestehende SAP-Landschaft bleibt unverändert und muss nicht transformiert oder migriert werden. Sie fungiert weiterhin als das zentrale System für die geschäftlichen Daten, auf die KI-Systeme über standardisierte Schnittstellen wie OData oder REST zugreifen können. Die Ergebnisse der KI-Analysen lassen sich dann über die APIs auch wieder zurückspielen – typischerweise im JSON-Format – und in den SAP-Anwendungen oder anderen, selbst erstellten Tools anzeigen. Diese Tools können mit dem Fiori genannten Designsystem von SAP im gleichen Look and Feel wie die SAP-Anwendungen gestaltet werden, sodass die Benutzererfahrung einheitlich ist und sich Anwender schnell zurechtfinden.
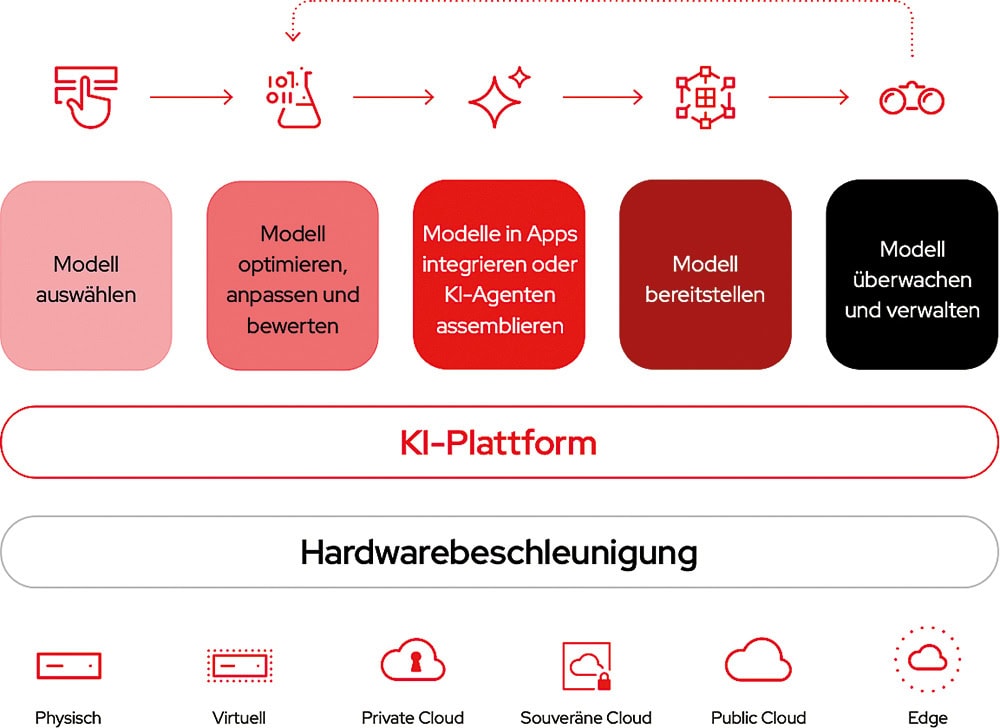
Der Ansatz, die KI außerhalb der SAP-Systeme zu betreiben, bietet dabei gleich mehrere Vorteile. Zum einen können Unternehmen die KI-Systeme unabhängig von den Kernsystemen entwickeln, was eine schnelle Realisierung und Bereitstellung erlaubt und die kontinuierliche Pflege erleichtert. Der SAP-Core bleibt unangetastet, sodass es später keine Kompatibilitätsprobleme bei Updates und Upgrades gibt. Zum anderen sind Unternehmen nicht auf bestimmte KI-Modelle festgelegt, sondern können frei wählen. Somit steht neben zahlreichen Large Language Models (LLMs) auch eine große Bandbreite an Small Language Models (SLMs) bereit. Diese verfügen nicht über das breite Allgemeinwissen von LLMs mit Milliarden von Parametern, dafür aber über detailliertes Spezialwissen in einzelnen Bereichen, das in vielen Anwendungsfällen zu besseren Ergebnissen führt. Darüber hinaus ist der Ressourcenbedarf der kleinen Modelle deutlich geringer, sodass weniger leistungsstarke Hardware benötigt wird und sowohl die Anschaffungs- als auch die Betriebskosten der Systeme niedriger ausfallen.
Freie Modellauswahl
Die Freiheit, KI-Modelle flexibel auswählen zu können, erlaubt es, bei Bedarf zu wechseln – etwa, wenn bessere Modelle oder Modellversionen auf den Markt kommen oder sich die Anforderungen des Unternehmens ändern. Zudem ist der gezielte Griff zu Open-Source-Modellen möglich, die Vorteile hinsichtlich der Nachvollziehbarkeit und Erklärbarkeit von Entscheidungen bieten. Anders als viele proprietäre Modelle agieren sie nicht als Blackbox, bei der völlig unklar bleibt, wie sie zu ihren Ergebnissen kommen. Ihre Transparenz ist vor allem in stark regulierten Branchen wichtig, aber auch überall dort, wo es darum geht, deterministische Ergebnisse zu erzielen. Schließlich muss die KI beispielsweise in Bereichen der funktionalen Sicherheit oder bei medizinischen Diagnosen, Kreditentscheidungen sowie bei der Bewertung von Bewerbern bei gleichem Input immer denselben Output liefern und darf sich nicht unvorhersehbar verhalten.
Neben dem von SAP selbst bereitgestellten SAP-RPT-1 sind bewährte Modellfamilien für die Auswertung von geschäftlichen Daten aus SAP-Systemen unter anderem IBM Granite, LLaMA und Mistral.
Im Unterschied zu den in der Cloud laufenden Modellen der KI-Platzhirsche und Hyperscaler lassen sich diese innerhalb der eigenen Infrastruktur bereitgestellten Modelle flexibel um unternehmensspezifisches Know-how erweitern, ohne dass sensible Daten außer Haus gelangen. Die Modelle verfügen also nicht nur über das vorab vom Anbieter beziehungsweise der Community antrainierte Wissen, sondern auch interne Expertise, die sich aus Datenbanken, Fileshares und eben SAP-Systemen speist. Die dort gespeicherten Informationen können über ein Finetuning direkt ins Modell integriert oder über Retrieval Augmented Generation (RAG) angebunden werden.
Wissensbasis für KI-Modelle
Ein Finetuning verbessert neben dem Wissen auch das kontextuelle Verständnis des Modelles und seine generativen Fähigkeiten hinsichtlich fachspezifischer Terminologie, ist allerdings vergleichsweise aufwendig. Unternehmen benötigen leistungsstarke IT-Systeme, in der Regel teure GPU-Cluster, weshalb es häufig in der Cloud stattfindet. In diesem Fall müssen Daten anonymisiert oder synthetische Daten für das Training generiert werden. Anschließend wird das Modell on-premises betrieben und verarbeitet die echten Unternehmensdaten ausschließlich innerhalb der eigenen Infrastruktur. Soll neues Wissen in das Modell einfließen, ist ein neuerliches Training erforderlich – der Aufwand ist also groß. Das von IBM und Red Hat ins Leben gerufene Open-Source-Projekt InstructLab unterstützt daher bei Finetunings und Re-Trainings, indem es Modellanpassungen durch ein spezielles Verfahren mit weniger Daten ermöglicht, hochwertige synthetische Daten bereitstellt und Rechenressourcen einspart. Es senkt die Einstiegshürden für Modellanpassungen deutlich – insbesondere für Unternehmen, denen es an KI-Experten und Data Scientists fehlt.
Bei RAG hingegen greift das Modell auf eine Vektordatenbank mit den Unternehmensinformationen zu. Auf diese Weise lässt sich die Wissensbasis leichter aktualisieren und die Ergebnisse der KI können gut um Quellenangaben ergänzt werden, sodass Mitarbeiter in der Lage sind, die Ergebnisse zu verifizieren. Das kontextuelle Verständnis und die generativen Fähigkeiten bleiben unverändert – für viele Anwendungsfälle, bei denen es nur um Datenanalysen geht, ist das aber völlig ausreichend. Beide Ansätze lassen sich bei Bedarf auch kombinieren, um einem Modell etwa fachspezifische Begriffe beizubringen und es mit stets aktuellen Daten zu versorgen.
Effizientes Inferencing
Der anschließende Betrieb der KI-Modelle innerhalb der eigenen Infrastruktur bietet über die Kontrolle der Unternehmensdaten hinaus den großen Vorteil, dass die KI in der Nähe der Daten läuft, diese also nicht erst aufwendig zur KI gebracht werden müssen. Umfangreiche Datenübertragungen in die Cloud sind somit nicht notwendig, sodass Unternehmen hohe Netzwerkkosten vermeiden. Sie benötigen allerdings lokale Infrastrukturen für das sogenannte Inferencing – das Treffen von Entscheidungen und die Generierungen von Antworten auf Basis von Daten und Anfragen. Die Anforderungen sind geringer als beim Training und Finetuning, bei wachsenden Nutzerzahlen oder der Umsetzung weiterer KI-Projekte kann auch das Inferencing schnell ressourcenintensiv werden. Ein effizienter Inferenzserver, der GPUs und deren Speicher optimal auslastet, hilft, Hardware-Kosten zu senken und KI-Anwendungen zu beschleunigen, sodass Anwender nicht lange auf Antworten warten müssen.
Die Herausforderung beim Side-by-Side-Modell liegt für Unternehmen letztlich vor allem darin, die Modelle für verschiedene Anwendungsfälle konsistent zu hosten, anzupassen, bereitzustellen und zu überwachen. Schließlich sollen die Abläufe und Rahmenbedingungen möglichst einheitlich bleiben – nicht nur aus Gründen der Effizienz und um das Entstehen von KI-Silos zu vermeiden. Auch Sicherheits- und Datenschutzanforderungen lassen sich auf diese Weise leichter einhalten, unter anderem durch zentrale Guardrails. Diese Schutzmechanismen prüfen sämtliche Ein- und Ausgaben und verhindern, dass die KI manipuliert wird oder fehlerhafte beziehungsweise unerwünschte Ergebnisse liefert. Damit helfen sie auch, ethische Standards einzuhalten und das Vertrauen in die Systeme zu stärken.
Ein konsistentes Monitoring stellt darüber hinaus eine gleichbleibend hohe Modellperformance sicher. Es erkennt Verzerrungen, die zu unfairen oder diskriminierenden Ergebnissen führen, ebenso wie Modell-Drifts – also eine nachlassende Qualität der Antworten, weil etwa die ursprünglich für das Training des Modells verwendeten Daten nicht mehr zeitgemäß sind oder neu hinzukommende Daten das Modell beeinflussen. Solche Drifts erfolgen meist unmerklich im Laufe der Zeit und lassen sich ohne Monitoring-Tools nur schwer entdecken.
Basis: Integrierte Plattform
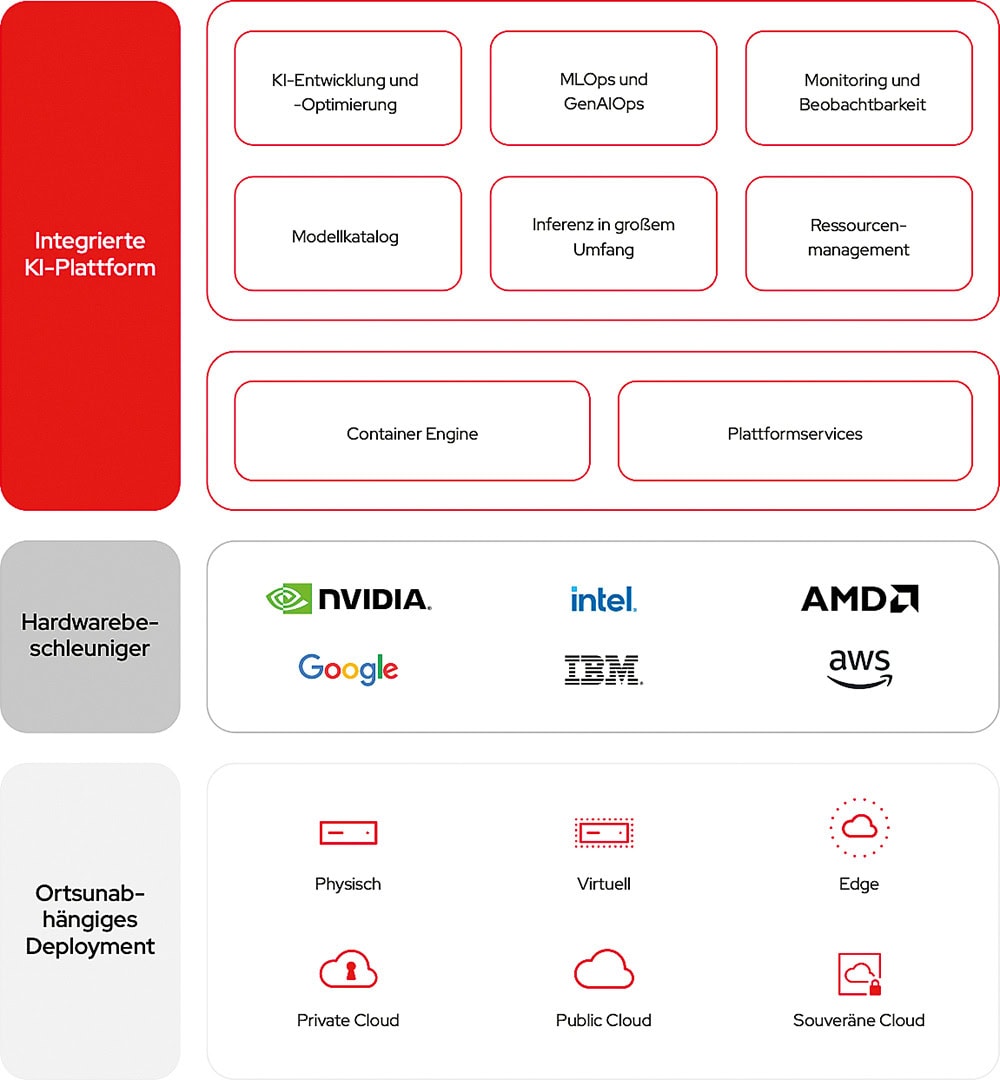
Idealerweise setzen Unternehmen für den Aufbau einer KI-Architektur neben den SAP-Systemen auf eine integrierte Plattform, die SAP nahtlos anbindet und alles mitbringt, was für die konsistente Verwaltung verschiedenster KI-Modelle über ihren gesamten Lebenszyklus hinweg benötigt wird. Red Hat stellt mit Red Hat AI Enterprise eine solche Plattform bereit. Sie basiert auf Red Hat OpenShift, das als Hybrid-Cloud-Anwendungsplattform die Anpassung und den Betrieb von Modellen und Anwendungen in hybriden Umgebungen unterstützt, sodass Unternehmen sie nicht nur für die KI-Integration in SAP im Rahmen des Side-by-Side-Modells einsetzen können, sondern für sämtliche KI-Workloads – unabhängig davon, ob diese im eigenen Rechenzentrum, am Edge oder in der Cloud laufen oder ob es sich um physische, virtualisierte oder containerisierte Umgebungen handelt. Red Hat AI Enterprise unterstützt ein breites Ökosystem von Open-Source-KI-Modellen und Hardware-Beschleunigern, sodass Unternehmen flexibel bleiben. Der integrierte Inferenz-Server basiert auf der quelloffenen Inference Engine vLLM, die nahtlos skaliert und eine effiziente GPU-Nutzung sowie stabile, niedrige Latenzen mit einem offenen, portierbaren Deployment vereint. Hinzu kommen Tools, die die Verwaltung von Modellen und Anwendungen automatisieren und GenAIOps- sowie MLOps-Ansätze fördern. Dahinter verbergen sich Praktiken, die – ähnlich wie DevOps bei anderen Anwendungen – eine schnelle inkrementelle und iterative Weiterentwicklung ermöglichen und die Zusammenarbeit zwischen Data Scientists, AI Engineers, Entwicklern und den verschiedenen IT-Betriebsteams verbessern.
Das Side-by-Side-Modell erlaubt es Unternehmen, ihre SAP-Systeme um fortschrittliche KI-Funktionen zu erweitern. Beispielsweise können Finanzdaten für KI-basierte Abgleiche mit Rechnungen genutzt werden, um Anomalien zu erkennen und Betrugsversuche zu verhindern. KI kann Lagerbestände in Abhängigkeit von Wetter und aktuellen Ereignissen optimieren und bei Bedarf etwa Bestellungen auslösen. Sie kann Jobbeschreibungen aus SAP nutzen, um eingehende Bewerbungen vorzusortieren. Oder sie übernimmt die Auswertung von Kamerabildern in der Fertigung, um Produktionsmängel aufzuspüren, und trägt die Ergebnisse anschließend in die SAP-Systeme ein. Die Einsatzmöglichkeiten sind äußerst vielfältig und der Fantasie im Grunde kaum Grenzen gesetzt.
Natürlich brauchen Unternehmen einiges an Know-how, um KI selbst anzupassen und zu betreiben. Der Aufbau lohnt allerdings, weil er Unabhängigkeit garantiert: Es ist jederzeit möglich, Modelle anzupassen oder zu wechseln – gerade in der schnelllebigen KI-Welt kann diese Fähigkeit äußerst wertvoll sein. Zudem hilft KI-Expertise in der Zukunft bei der Umsetzung weiterer Anwendungsfälle und kann langfristig auch Geld sparen. Schließlich entstehen in der Cloud oft überraschend hohe Kosten, gerade wenn Nutzerzahlen wachsen oder neue KI-Anwendungen hinzukommen. Der Weg zurück ins eigene Rechenzentrum ist dann aber oft verbaut, weil die entsprechenden Infrastrukturen und das notwendige Wissen mittlerweile fehlen.
Beim Aufbau der Expertise und der Durchführung der initialen KI-Projekte ist der Wert von erfahrenen Partnern allerdings nicht zu unterschätzen. Sie tragen Wissen ins Unternehmen und verhindern, dass der Fokus verloren geht und Endlosprojekte entstehen, die es nie in den Produktivbetrieb schaffen. Letztlich bietet das Side-by-Side-Modell damit eine pragmatische Lösung nicht nur für aktuelle, sondern auch für künftige Herausforderungen von Unternehmen mit klassischen SAP-Umgebungen.
Zum Partnereintrag:
 Deutsch
 English
 Español
 Français