L'intelligence artificielle sans obligation de recourir au cloud : SAP et l'IA – main dans la main
Depuis déjà deux ou trois ans, SAP s'emploie activement à intégrer l'intelligence artificielle dans ses solutions, tout en se concentrant sur les dernières versions de S/4 HANA et sur le cloud SAP. Le groupe de logiciels de Walldorf parvient ainsi à convaincre les nouveaux clients : selon Christian Klein, directeur général de SAP, deux tiers des nouveaux contrats comprennent désormais des composants d’IA. Pour de nombreux clients existants, le passage à S/4 Hana et au cloud n’est toutefois pas envisageable, car ils disposent d’environnements locaux complexes, parfois développés au fil de plusieurs décennies, fonctionnant sous SAP ECC. Leur migration serait extrêmement complexe et coûteuse, et prendrait probablement plusieurs années. Le travail minutieux de personnalisation réalisé par le passé serait en grande partie perdu.
À cela s'ajoute le fait que de plus en plus d'entreprises accordent désormais de l'importance à la souveraineté des données et se montrent particulièrement sceptiques quant à l'externalisation de données et de systèmes critiques pour leur activité vers les clouds des hyperscalers. Elles craignent une perte de contrôle et des dépendances difficiles à résoudre en cas de besoin, de sorte qu’en cas d’augmentation soudaine des coûts, de modifications fonctionnelles importantes ou de restrictions d’accès aux services, il est pratiquement impossible de changer facilement de fournisseur. Selon une étude de Red Hat, par exemple, seules 57 % des entreprises allemandes disposent d’une stratégie de sortie définie pour leur principal fournisseur d’IA, et même parmi ces entreprises, 37 % s’attendent à des répercussions modérées à importantes sur la continuité de leurs activités si elles devaient effectivement changer de fournisseur.
Distinction entre SAP et l'IA
Indépendamment de cela, il existe, selon les secteurs d’activité, des exigences réglementaires plus ou moins strictes en matière de gestion des données, qui empêchent plus ou moins de nombreuses entreprises, notamment dans les secteurs de la finance et de la santé, de migrer vers le cloud. En matière d’utilisation de l’IA dans l’univers SAP, elles se retrouvent ainsi exclues et ne peuvent pas exploiter la mine de données issue de leurs systèmes SAP pour acquérir de nouvelles connaissances et améliorer leurs processus ainsi que leurs prises de décision – du moins pas avec les composants d’IA fournis par SAP, tels que SAP Joule.
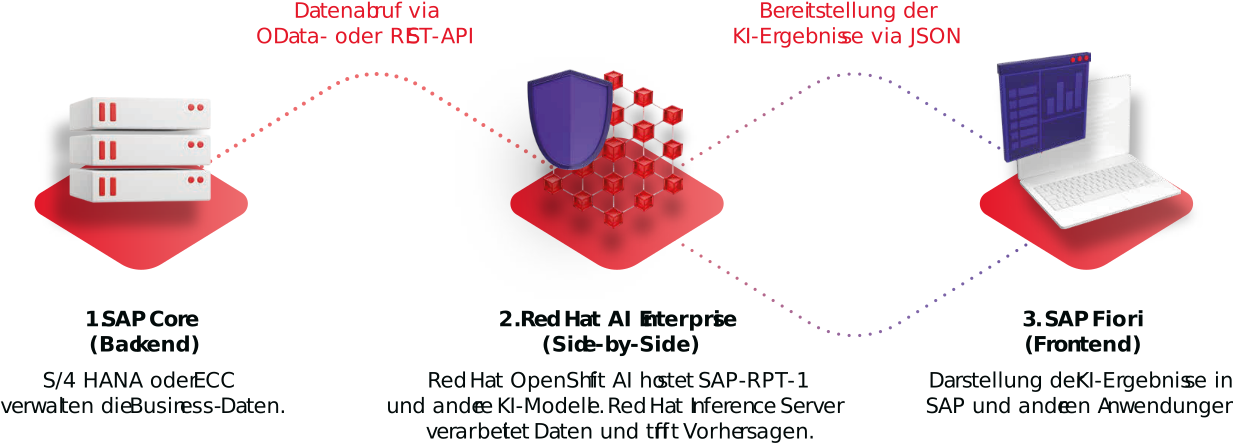
Il est certes possible d'enrichir les systèmes existants fonctionnant sur site avec des modules complémentaires tiers intégrant l'IA. Cependant, bon nombre de ces modules sont eux-mêmes basés sur le cloud et s'accompagnent de dépendances et, bien souvent, de coûts considérables. Le modèle « side-by-side » constitue en revanche une approche intéressante pour intégrer l’IA dans l’environnement SAP classique. Dans ce modèle, les systèmes d’IA restent séparés des systèmes SAP centraux et sont exploités dans une architecture distincte, mais étroitement connectée. L’environnement SAP existant reste inchangé et ne nécessite ni transformation ni migration. Il continue de servir de système central pour les données métier, auxquelles les systèmes d’IA peuvent accéder via des interfaces standardisées telles que OData ou REST. Les résultats des analyses d’IA peuvent ensuite être renvoyés via les API – généralement au format JSON – et affichés dans les applications SAP ou dans d’autres outils développés en interne. Ces outils peuvent être conçus à l’aide du système de conception de SAP appelé Fiori, avec la même interface que les applications SAP, ce qui garantit une expérience utilisateur cohérente et permet aux utilisateurs de s’y retrouver rapidement.
L'approche consistant à exploiter l'IA en dehors des systèmes SAP offre plusieurs avantages. D'une part, les entreprises peuvent développer les systèmes d'IA indépendamment des systèmes centraux, ce qui permet une mise en œuvre et un déploiement rapides et facilite la maintenance continue. Le cœur du système SAP reste intact, ce qui évite tout problème de compatibilité lors des mises à jour et des mises à niveau ultérieures. D’autre part, les entreprises ne sont pas limitées à certains modèles d’IA, mais peuvent choisir librement. Ainsi, outre les nombreux grands modèles linguistiques (LLM), une large gamme de petits modèles linguistiques (SLM) est également disponible. Ceux-ci ne disposent pas de la vaste culture générale des LLM, qui comptent des milliards de paramètres, mais possèdent en revanche des connaissances spécialisées détaillées dans des domaines spécifiques, ce qui conduit à de meilleurs résultats dans de nombreux cas d’utilisation. De plus, les besoins en ressources des petits modèles sont nettement moindres, ce qui permet de se passer d’un matériel aussi puissant et réduit ainsi tant les coûts d’acquisition que les coûts d’exploitation des systèmes.
Libre choix du modèle
La liberté de pouvoir choisir des modèles d’IA de manière flexible permet d’en changer si nécessaire – par exemple, lorsque de meilleurs modèles ou de nouvelles versions de modèles apparaissent sur le marché, ou lorsque les besoins de l’entreprise évoluent. De plus, il est possible de recourir de manière ciblée à des modèles open source, qui offrent des avantages en termes de traçabilité et d’explicabilité des décisions. Contrairement à de nombreux modèles propriétaires, ils ne fonctionnent pas comme une « boîte noire », dont le fonctionnement reste totalement opaque. Leur transparence est particulièrement importante dans les secteurs fortement réglementés, mais aussi partout où il s’agit d’obtenir des résultats déterministes. Enfin, dans des domaines tels que la sécurité fonctionnelle, les diagnostics médicaux, les décisions de crédit ou l’évaluation des candidats, l’IA doit toujours fournir le même résultat pour une même entrée et ne doit pas se comporter de manière imprévisible.
Outre SAP-RPT-1, fourni par SAP lui-même, il existe d'autres familles de modèles éprouvées pour l'analyse des données métier issues des systèmes SAP, notamment IBM Granite, LLaMA et Mistral.
Contrairement aux modèles des leaders du secteur de l'IA et des hyperscalers, qui fonctionnent dans le cloud, ces modèles déployés au sein de l'infrastructure interne de l'entreprise peuvent être enrichis de manière flexible par un savoir-faire spécifique à l'entreprise, sans que des données sensibles ne sortent de l'entreprise. Les modèles disposent donc non seulement des connaissances préalablement entraînées par le fournisseur ou la communauté, mais aussi d’une expertise interne alimentée par des bases de données, des partages de fichiers et, justement, des systèmes SAP. Les informations qui y sont stockées peuvent être intégrées directement dans le modèle via un réglage fin ou connectées via la technologie RAG (Retrieval Augmented Generation).
Base de connaissances pour les modèles d'IA
Un ajustement fin améliore non seulement les connaissances, mais aussi la compréhension contextuelle du modèle et ses capacités génératives en matière de terminologie spécifique au domaine ; il s'agit toutefois d'un processus relativement coûteux. Les entreprises ont besoin de systèmes informatiques puissants, généralement des clusters de GPU onéreux, ce qui explique pourquoi ce processus s'effectue souvent dans le cloud. Dans ce cas, les données doivent être anonymisées ou des données synthétiques doivent être générées pour l’entraînement. Le modèle est ensuite exploité sur site et traite les données réelles de l’entreprise exclusivement au sein de sa propre infrastructure. Si de nouvelles connaissances doivent être intégrées au modèle, un nouvel entraînement est nécessaire – l’effort requis est donc considérable. Le projet open source InstructLab, lancé par IBM et Red Hat, facilite donc les ajustements et les ré-entraînements en permettant d’adapter les modèles grâce à un procédé spécifique nécessitant moins de données, en fournissant des données synthétiques de haute qualité et en économisant des ressources de calcul. Il réduit considérablement les obstacles à l’adaptation des modèles, en particulier pour les entreprises qui manquent d’experts en IA et de data scientists.
Chez RAG, en revanche, le modèle accède à une base de données vectorielle contenant les informations sur l'entreprise. Cela facilite la mise à jour de la base de connaissances et permet d'accompagner les résultats de l'IA de références précises, ce qui permet aux collaborateurs de vérifier ces résultats. La compréhension contextuelle et les capacités génératives restent inchangées – mais cela est tout à fait suffisant pour de nombreux cas d’utilisation qui ne concernent que l’analyse de données. Les deux approches peuvent également être combinées si nécessaire, par exemple pour enseigner à un modèle des termes spécifiques à un domaine et lui fournir des données toujours à jour.
Inférence efficace
L'exploitation ultérieure des modèles d'IA au sein de l'infrastructure propre à l'entreprise offre, outre le contrôle des données de l'entreprise, le grand avantage que l'IA fonctionne à proximité des données, ce qui évite de devoir les transférer vers l'IA, une opération qui peut s'avérer fastidieuse. Les transferts de données volumineux vers le cloud ne sont donc pas nécessaires, ce qui permet aux entreprises d'éviter des coûts de réseau élevés. Elles ont toutefois besoin d’infrastructures locales pour ce qu’on appelle l’« inférence » : la prise de décisions et la génération de réponses sur la base de données et de requêtes. Les exigences sont moindres que pour l’entraînement et le réglage fin, mais avec l’augmentation du nombre d’utilisateurs ou la mise en œuvre d’autres projets d’IA, l’inférence peut rapidement devenir gourmande en ressources. Un serveur d’inférence efficace, qui exploite de manière optimale les GPU et leur mémoire, contribue à réduire les coûts matériels et à accélérer les applications d’IA, de sorte que les utilisateurs n’aient pas à attendre longtemps pour obtenir des réponses.
En fin de compte, le principal défi que pose le modèle « side-by-side » pour les entreprises réside avant tout dans la nécessité d’héberger, d’adapter, de déployer et de surveiller les modèles de manière cohérente pour différents cas d’utilisation. En effet, les processus et les conditions-cadres doivent rester aussi uniformes que possible – non seulement pour des raisons d’efficacité et pour éviter la création de « silos » d’IA, mais aussi parce que cela facilite le respect des exigences en matière de sécurité et de protection des données, notamment grâce à des garde-fous centralisés. Ces mécanismes de protection vérifient l’ensemble des entrées et des sorties et empêchent que l’IA ne soit manipulée ou ne fournisse des résultats erronés ou indésirables. Ils contribuent ainsi à respecter les normes éthiques et à renforcer la confiance dans les systèmes.
Un suivi rigoureux garantit en outre un niveau de performance élevé et constant du modèle. Elle permet de détecter les biais qui conduisent à des résultats inéquitables ou discriminatoires, ainsi que les dérives du modèle – c'est-à-dire une baisse de la qualité des réponses, due par exemple au fait que les données initialement utilisées pour l'entraînement du modèle ne sont plus à jour ou que de nouvelles données viennent influencer le modèle. Ces dérives se produisent généralement de manière imperceptible au fil du temps et sont difficiles à détecter sans outils de surveillance.
Base : plateforme intégrée
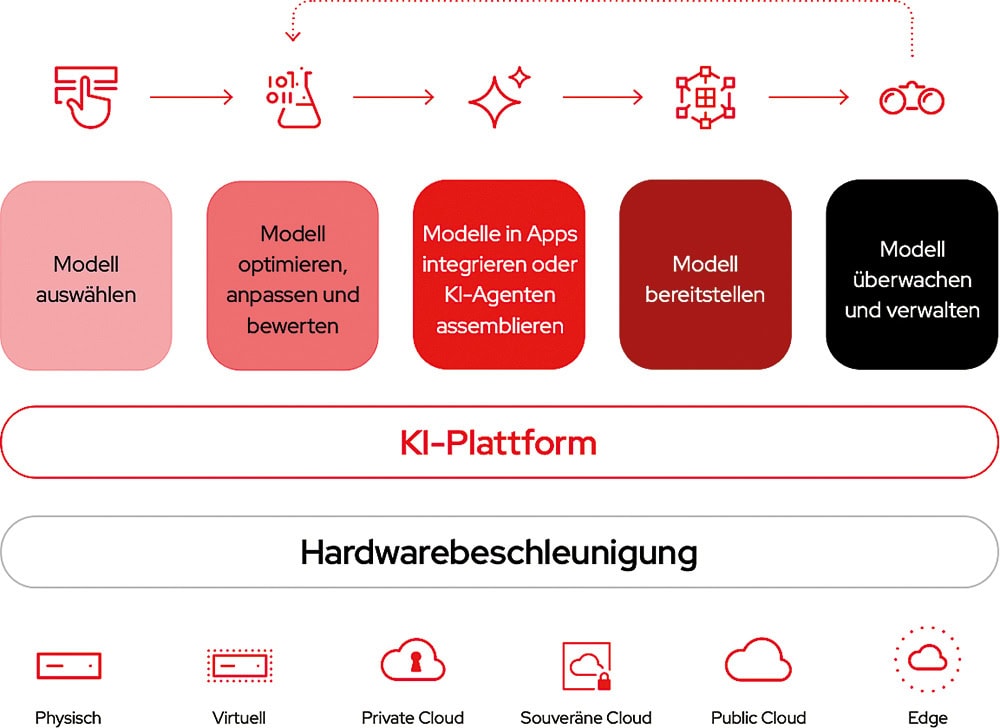
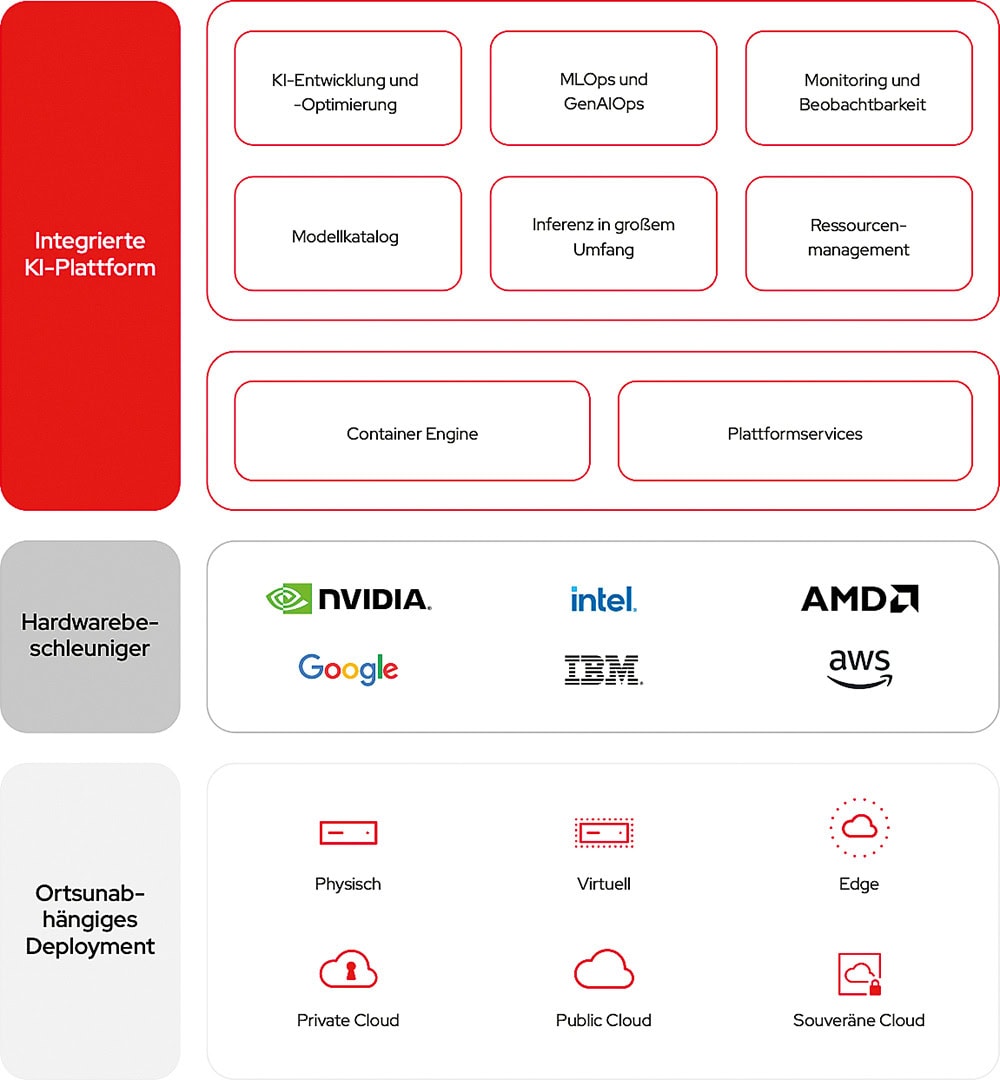
Idéalement, pour mettre en place une architecture d’IA, les entreprises s’appuient, en plus des systèmes SAP, sur une plateforme intégrée qui s’interface de manière transparente avec SAP et offre tout ce qui est nécessaire à la gestion cohérente d’une grande variété de modèles d’IA tout au long de leur cycle de vie. Red Hat propose une telle plateforme avec Red Hat AI Enterprise. Elle repose sur Red Hat OpenShift, une plateforme d’applications en cloud hybride qui prend en charge la personnalisation et l’exploitation de modèles et d’applications dans des environnements hybrides, permettant ainsi aux entreprises de l’utiliser non seulement pour l’intégration de l’IA dans SAP dans le cadre du modèle « side-by-side », mais aussi pour l’ensemble des charges de travail d’IA , qu’elles s’exécutent dans leur propre centre de données, en périphérie ou dans le cloud, et qu’il s’agisse d’environnements physiques, virtualisés ou conteneurisés. Red Hat AI Enterprise prend en charge un vaste écosystème de modèles d’IA open source et d’accélérateurs matériels, permettant ainsi aux entreprises de conserver leur flexibilité. Le serveur d’inférence intégré repose sur le moteur d’inférence open source vLLM, qui s’adapte en toute transparence et allie une utilisation efficace des GPU à des latences faibles et stables, le tout dans un déploiement ouvert et portable. À cela s’ajoutent des outils qui automatisent la gestion des modèles et des applications et favorisent les approches GenAIOps et MLOps. Derrière ces concepts se cachent des pratiques qui, à l’instar du DevOps pour d’autres applications, permettent un développement rapide, incrémental et itératif, tout en améliorant la collaboration entre les data scientists, les ingénieurs en IA, les développeurs et les différentes équipes d’exploitation informatique.
Le modèle « side-by-side » permet aux entreprises d’enrichir leurs systèmes SAP de fonctionnalités avancées d’IA. Par exemple, les données financières peuvent être utilisées pour effectuer des recoupements basés sur l’IA avec les factures, afin de détecter les anomalies et de prévenir les tentatives de fraude. L’IA peut optimiser les niveaux de stock en fonction des conditions météorologiques et de l’actualité, et déclencher des commandes si nécessaire. Elle peut utiliser les descriptions de poste issues de SAP pour présélectionner les candidatures reçues. Elle peut également se charger de l’analyse des images de caméras dans les ateliers de production afin de détecter les défauts de fabrication, puis enregistrer les résultats dans les systèmes SAP. Les possibilités d’application sont extrêmement variées et l’imagination n’a pratiquement aucune limite.
Bien sûr, les entreprises ont besoin d’un certain savoir-faire pour adapter et exploiter elles-mêmes l’IA. Mais cet investissement en vaut la peine, car il garantit l’indépendance : il est possible à tout moment d’adapter ou de changer de modèles – une capacité qui peut s’avérer extrêmement précieuse, surtout dans le monde en constante évolution de l’IA. De plus, l’expertise en IA aidera à l’avenir à mettre en œuvre d’autres cas d’utilisation et peut également permettre de réaliser des économies à long terme. Enfin, le cloud engendre souvent des coûts étonnamment élevés, notamment lorsque le nombre d’utilisateurs augmente ou que de nouvelles applications d’IA viennent s’ajouter. Or, il est alors souvent impossible de revenir à son propre centre de données, car les infrastructures correspondantes et les connaissances nécessaires font désormais défaut.
Lorsqu’il s’agit de développer l’expertise et de mener à bien les premiers projets d’IA, il ne faut toutefois pas sous-estimer l’importance de partenaires expérimentés. Ceux-ci apportent leur savoir-faire à l’entreprise et évitent que l’on perde de vue l’objectif principal et que l’on se lance dans des projets interminables qui ne verront jamais le jour en production. En fin de compte, le modèle « side-by-side » offre ainsi une solution pragmatique non seulement pour les défis actuels, mais aussi pour les défis futurs des entreprises disposant d’environnements SAP classiques.
Vers l'inscription du partenaire :
 Deutsch
 English
 Español
 Français