Hana-Power-Engines: Graph y Vector
ERP determinista frente a agentes de IA estocásticos
La necesidad de implementar en paralelo tanto un motor vectorial como un motor de grafos en la plataforma de bases de datos SAP HANA tiene su origen en la discrepancia arquitectónica fundamental entre la inteligencia artificial estocástica y el software empresarial determinista.
Un sistema ERP moderno como S/4 Hana exige en el libro mayor transaccional una precisión absoluta, una seguridad de auditoría trazable y relaciones contables fijas. Por el contrario, los grandes modelos de lenguaje (LLM) funcionan de forma probabilística, basándose en probabilidades estadísticas. El uso aislado de modelos de lenguaje generativos conduce inevitablemente a «alucinaciones» en el día a día de la empresa, ya que un LLM puro no comprende ni el complejo esquema relacional formado por decenas de miles de tablas ni las relaciones dinámicas en tiempo real.
Generación aumentada por recuperación
Es en este punto donde entra en juego el Hana Cloud Vector Engine, que almacena vectores de forma nativa a través de tipos de datos y los compara mediante medidas de distancia matemáticas, como la similitud coseno o la distancia euclidiana. Los vectores traducen datos no estructurados —como facturas, textos libres, catálogos de productos, tickets de asistencia técnica o actas— a espacios vectoriales multidimensionales mediante modelos de incrustación.
De este modo, Vector Engine actúa como un filtro matemático de similitud para el método clásico de «Retrieval-Augmented Generation» (RAG): ante una consulta, extrae en tiempo real fragmentos de texto semánticamente relacionados como los K resultados principales y los transmite como contexto de referencia al copiloto de IA Joule o a los modelos de lenguaje.
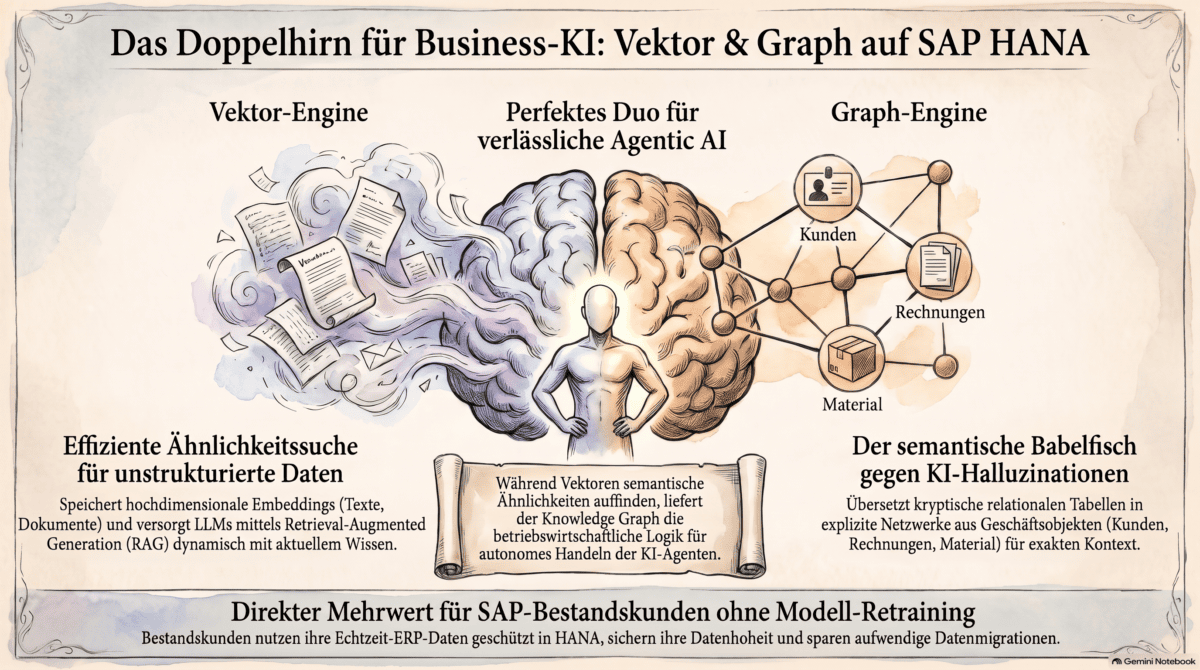
Sin embargo, por sí solo, el modelo vectorial se ve limitado por las reglas de negocio relacionales, ya que solo representa proximidades estadísticas entre palabras y textos, pero no puede desglosa las dependencias empresariales, como la cadena que va desde la solicitud de pedido, pasando por la entrada de mercancías, hasta la comprobación de facturas.
Gráfico de conocimientos SAP
Por este motivo, SAP necesita imperativamente el motor Hana Graph Engine, que se basa en la teoría matemática de grafos y constituye la base técnica del SAP Knowledge Graph dentro de la Business Data Cloud (SAP BDC). El motor de grafos no modela los datos empresariales en espacios vectoriales multidimensionales ni en filas rígidas de tablas SQL, sino como una red explícita de relaciones formada por nodos y aristas, basada en ontologías y estándares del W3C como RDF y SPARQL.
El Knowledge Graph integra el complejo modelo de datos relacional de S/4, compuesto por más de siete millones de campos de datos, con la lógica semántica de los procesos. En cierto modo, proporciona a los modelos de lenguaje (LLM) y a los agentes autónomos de IA el modelo de datos empresariales (ontología) y la brújula semántica, al definir con exactitud qué es un pedido de cliente, una sociedad o un maestro de proveedores, y cómo se relacionan entre sí estas entidades. Solo estos modelos de relaciones explícitos permiten a los sistemas extraer conclusiones lógicas más allá de los límites del dominio y evitar de forma eficaz las «alucinaciones» erróneas de la IA en el núcleo transaccional.
GraphRAG como salida a las alucinaciones de la IA
Para los clientes actuales de SAP, el verdadero valor añadido surge de la fusión sinérgica de ambos mundos en el denominado GraphRAG. Los agentes autónomos de IA, cuyo objetivo es ejecutar de forma autónoma procesos de trabajo en el ámbito de las compras, la gestión de la cadena de suministro o el cierre financiero, necesitan tanto intuición probabilística como pautas deterministas.
Mientras que el Vector Engine permite al agente registrar consultas no estructuradas en lenguaje natural, realizar búsquedas semánticas en documentos relevantes y depurar los datos maestros de clientes con información ruidosa mediante la agrupación en clústeres y la detección de duplicados, el Graph Engine proporciona el contexto de ejecución completo y el historial de datos (linaje).
Si, por ejemplo, un agente necesita determinar qué tabla base subyace a una vista CDS concreta o qué matriz de autorizaciones se aplica a un contrato de compra crítico, navega de forma determinista a través de los enlaces del grafo de conocimiento. De este modo se crea una base de decisión fiable, en la que el agente actúa exactamente dentro del marco de las autorizaciones establecidas y los requisitos de cumplimiento normativo.
La plataforma multimodelo de Hana
La fortaleza arquitectónica de la plataforma de base de datos Hana radica en que está concebida como una plataforma multimodelo integrada. En lugar de tener que gestionar y sincronizar, para los datos transaccionales relacionales, búsquedas vectoriales y grafos de conocimiento, HANA consolida tablas relacionales SQL, objetos de grafos y datos vectoriales en una única plataforma en memoria. Esto permite realizar consultas híbridas en las que los filtros relacionales de la empresa (como sociedades, mandantes o autorizaciones) pueden combinarse directamente en la misma instrucción SQL con la similitud coseno del motor vectorial y vincularse con análisis de rutas del motor de grafos. Esto elimina las replicaciones de datos ETL, propensas a errores, reduce los tiempos de latencia y garantiza que se mantenga la arquitectura de seguridad y autorizaciones del sistema ERP a nivel de base de datos.
Valor añadido para los clientes actuales de SAP. Sin embargo, desde una perspectiva crítica, los clientes actuales no deben pasar por alto que SAP presenta estos métodos matemáticos estándar ya consolidados —como la distancia euclidiana o las matrices de grafos— —, como una «revolución en la nube» exclusiva con el fin de empujar a los clientes hacia costosos modelos de suscripción y hacia la Business Data Cloud. Dado que el Hana Vector Engine y el Knowledge Graph se ofrecen principalmente como servicios en la nube en SAP BTP, los usuarios corren el riesgo de caer en una trampa de costes considerable debido a las unidades de capacidad basadas en el consumo y a la implacable caducidad de los créditos prepagados. Por ello, los responsables de TI con experiencia deberían aprovechar de forma específica las ventajas técnicas de los motores vectoriales y de grafos para dominar la RAG y la IA agentiva, pero, al mismo tiempo, deben asegurarse, mediante estándares de interfaz abiertos como el Model Context Protocol (MCP), de que su propia arquitectura de datos semántica no acabe en un bloqueo irreversible por parte del fabricante.
 Deutsch
 English
 Español
 Français