Inteligencia artificial sin dependencia de la nube: SAP y la IA, codo con codo
Desde hace ya dos o tres años, SAP impulsa con determinación la integración de la inteligencia artificial en sus soluciones, aunque se centra en las versiones actuales de S/4 HANA y en la nube de SAP. Con ello, el grupo de software de Walldorf consigue convencer a los nuevos clientes; al menos, según el director general de SAP, Christian Klein, dos tercios de los nuevos contratos incluyen ya componentes de IA. Sin embargo, para muchos clientes actuales, el cambio a S/4 Hana y a la nube no es una opción, ya que disponen de entornos locales complejos con SAP ECC, algunos de los cuales se han ido desarrollando a lo largo de décadas. Su migración sería extremadamente laboriosa y costosa, y probablemente llevaría varios años. La minuciosa personalización realizada en el pasado se perdería en gran medida.
A esto se suma que cada vez más empresas prestan atención a la soberanía de los datos y se muestran especialmente escépticas ante la externalización de datos y sistemas críticos para el negocio a las nubes de los hiperescaladores. Temen una pérdida de control y la aparición de dependencias que, en caso necesario, resulten difíciles de eliminar, de modo que, por ejemplo, ante aumentos repentinos de los costes, cambios funcionales importantes o restricciones en el acceso a los servicios, resulte prácticamente imposible cambiar fácilmente a otros proveedores. Según un estudio de Red Hat, por ejemplo, solo el 57 % de las empresas alemanas cuenta con una estrategia de salida definida para su proveedor principal de IA, y de estas empresas, el 37 % prevé que el cambio de proveedor tendría un impacto de moderado a considerable en su continuidad empresarial, en caso de que realmente tuvieran que llevarlo a cabo.
Separación entre SAP y la IA
Independientemente de ello, existen requisitos normativos de mayor o menor rigor, según el sector, en materia de gestión de datos, lo que hace que, para muchas empresas —entre otras, del sector financiero y sanitario—, el acceso a la nube siga estando más o menos vedado. Por lo tanto, en lo que respecta al uso de la IA en el entorno SAP, estas empresas quedan al margen y no pueden aprovechar el tesoro de datos de sus sistemas SAP para obtener nuevos conocimientos y mejorar los procesos y la toma de decisiones —al menos no con los componentes de IA que ofrece SAP, como SAP Joule—.
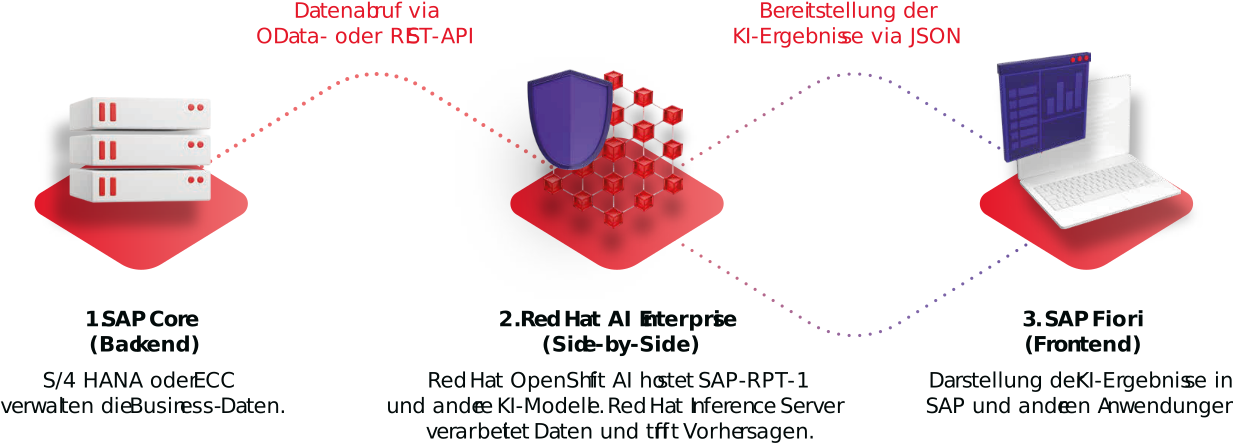
Si bien existe la posibilidad de ampliar con IA los sistemas existentes que se ejecutan en las propias instalaciones mediante complementos de terceros, muchos de estos complementos también están basados en la nube y conllevan dependencias y, a menudo, costes considerables. Por el contrario, el modelo «side-by-side» constituye un enfoque interesante para integrar la IA en el SAP clásico. En este caso, los sistemas de IA permanecen separados de los sistemas centrales de SAP y se ejecutan en una arquitectura independiente, pero estrechamente conectada. El entorno SAP existente permanece inalterado y no es necesario transformarlo ni migrarlo. Sigue actuando como el sistema central para los datos empresariales, a los que los sistemas de IA pueden acceder a través de interfaces estandarizadas como OData o REST. Los resultados de los análisis de IA pueden volver a transferirse a través de las API —normalmente en formato JSON— y visualizarse en las aplicaciones de SAP o en otras herramientas creadas por la propia empresa. Estas herramientas pueden diseñarse con el sistema de diseño de SAP denominado «Fiori» con el mismo aspecto y funcionamiento que las aplicaciones de SAP, de modo que la experiencia de usuario sea uniforme y los usuarios se orienten rápidamente.
El enfoque de ejecutar la IA fuera de los sistemas SAP ofrece varias ventajas. Por un lado, las empresas pueden desarrollar los sistemas de IA independientemente de los sistemas centrales, lo que permite una rápida implementación y puesta en marcha, y facilita el mantenimiento continuo. El núcleo de SAP permanece intacto, por lo que no surgen problemas de compatibilidad posteriores con las actualizaciones y mejoras. Por otro lado, las empresas no están limitadas a determinados modelos de IA, sino que pueden elegir libremente. De este modo, además de numerosos modelos de lenguaje grandes (LLM), se dispone de una amplia gama de modelos de lenguaje pequeños (SLM). Estos no cuentan con los amplios conocimientos generales de los LLM, con miles de millones de parámetros, pero sí disponen de conocimientos especializados detallados en áreas concretas, lo que conduce a mejores resultados en muchos casos de uso. Además, los requisitos de recursos de los modelos pequeños son considerablemente menores, por lo que se necesita un hardware menos potente y tanto los costes de adquisición como los de funcionamiento de los sistemas resultan más bajos.
Libre elección de modelo
La libertad de poder seleccionar modelos de IA de forma flexible permite cambiarlos cuando sea necesario, por ejemplo, cuando salgan al mercado modelos o versiones de modelos mejores, o cuando cambien los requisitos de la empresa. Además, es posible recurrir de forma específica a modelos de código abierto, que ofrecen ventajas en cuanto a la trazabilidad y la explicabilidad de las decisiones. A diferencia de muchos modelos propietarios, no funcionan como una «caja negra», en la que resulta totalmente opaco cómo llegan a sus resultados. Su transparencia es especialmente importante en sectores muy regulados, pero también en todos aquellos ámbitos en los que se trata de obtener resultados deterministas. Al fin y al cabo, la IA debe ofrecer siempre el mismo resultado para una misma entrada —por ejemplo, en ámbitos como la seguridad funcional, los diagnósticos médicos, las decisiones crediticias o la evaluación de candidatos— y no debe comportarse de forma impredecible.
Además de SAP-RPT-1, proporcionado por la propia SAP, existen otras familias de modelos de probada eficacia para el análisis de datos empresariales procedentes de sistemas SAP, como IBM Granite, LLaMA y Mistral, entre otras.
A diferencia de los modelos de los líderes del mercado de la IA y los hiperescaladores, que se ejecutan en la nube, estos modelos, que se implementan dentro de la propia infraestructura, pueden ampliarse de forma flexible con conocimientos específicos de la empresa, sin que los datos sensibles salgan de la empresa. Así pues, los modelos no solo cuentan con los conocimientos preentrenados por el proveedor o la comunidad, sino también con la experiencia interna que se nutre de bases de datos, recursos compartidos y, precisamente, sistemas SAP. La información almacenada en ellos puede integrarse directamente en el modelo mediante un ajuste fino o conectarse a través de la «Retrieval Augmented Generation» (RAG).
Base de conocimientos para modelos de IA
El ajuste fino mejora, además del conocimiento, la comprensión contextual del modelo y sus capacidades generativas en lo que respecta a la terminología específica del sector; sin embargo, resulta relativamente laborioso. Las empresas necesitan sistemas informáticos potentes, normalmente costosos clústeres de GPU, por lo que a menudo se lleva a cabo en la nube. En este caso, es necesario anonimizar los datos o generar datos sintéticos para el entrenamiento. Posteriormente, el modelo se ejecuta de forma local y procesa los datos reales de la empresa exclusivamente dentro de su propia infraestructura. Si se desea incorporar nuevos conocimientos al modelo, es necesario volver a entrenarlo, lo que supone un gran esfuerzo. Por ello, el proyecto de código abierto InstructLab, creado por IBM y Red Hat, facilita los ajustes de precisión y los nuevos entrenamientos, ya que permite adaptar los modelos mediante un procedimiento especial que requiere menos datos, proporciona datos sintéticos de alta calidad y ahorra recursos informáticos. Esto reduce considerablemente las barreras de entrada para los ajustes de los modelos, especialmente para aquellas empresas que carecen de expertos en IA y de científicos de datos.
En el caso de RAG, en cambio, el modelo accede a una base de datos vectorial con la información de la empresa. De este modo, la base de conocimientos se actualiza más fácilmente y los resultados de la IA pueden complementarse adecuadamente con referencias, de modo que los empleados puedan verificar dichos resultados. La comprensión contextual y las capacidades generativas no varían; sin embargo, para muchos casos de uso en los que solo se trata de análisis de datos, esto resulta totalmente suficiente. Ambos enfoques también pueden combinarse si es necesario, por ejemplo, para enseñar a un modelo términos específicos de un ámbito y proporcionarle datos siempre actualizados.
Inferencia eficiente
El posterior funcionamiento de los modelos de IA dentro de la propia infraestructura ofrece, además del control sobre los datos de la empresa, la gran ventaja de que la IA se ejecuta cerca de los datos, por lo que no es necesario realizar un laborioso traslado de estos hasta la IA. De este modo, no son necesarias transferencias masivas de datos a la nube, lo que permite a las empresas evitar elevados costes de red. Sin embargo, se necesitan infraestructuras locales para la denominada «inferencia»: la toma de decisiones y la generación de respuestas basadas en datos y consultas. Aunque los requisitos son menores que en el entrenamiento y el ajuste fino, a medida que aumenta el número de usuarios o se implementan más proyectos de IA, la inferencia también puede llegar a consumir rápidamente muchos recursos. Un servidor de inferencia eficiente, que aproveche de forma óptima las GPU y su memoria, ayuda a reducir los costes de hardware y a acelerar las aplicaciones de IA, de modo que los usuarios no tengan que esperar mucho tiempo para obtener respuestas.
En definitiva, el principal reto que plantea el modelo «side-by-side» para las empresas radica en alojar, adaptar, poner a disposición y supervisar los modelos de forma coherente para los distintos casos de uso. Al fin y al cabo, los procesos y las condiciones marco deben mantenerse lo más uniformes posible, y no solo por razones de eficiencia y para evitar la aparición de «silos» de IA. De esta forma también resulta más fácil cumplir los requisitos de seguridad y protección de datos, entre otras cosas mediante medidas de control centralizadas. Estos mecanismos de protección comprueban todas las entradas y salidas e impiden que la IA sea manipulada o que ofrezca resultados erróneos o no deseados. De este modo, también contribuyen a respetar las normas éticas y a reforzar la confianza en los sistemas.
Además, una supervisión constante garantiza un rendimiento del modelo siempre alto. Detecta sesgos que dan lugar a resultados injustos o discriminatorios, así como desviaciones del modelo —es decir, una disminución de la calidad de las respuestas debido, por ejemplo, a que los datos utilizados inicialmente para el entrenamiento del modelo ya no están actualizados o a que los nuevos datos que se incorporan influyen en el modelo—. Estas desviaciones suelen producirse de forma imperceptible con el paso del tiempo y son difíciles de detectar sin herramientas de seguimiento.
Base: plataforma integrada
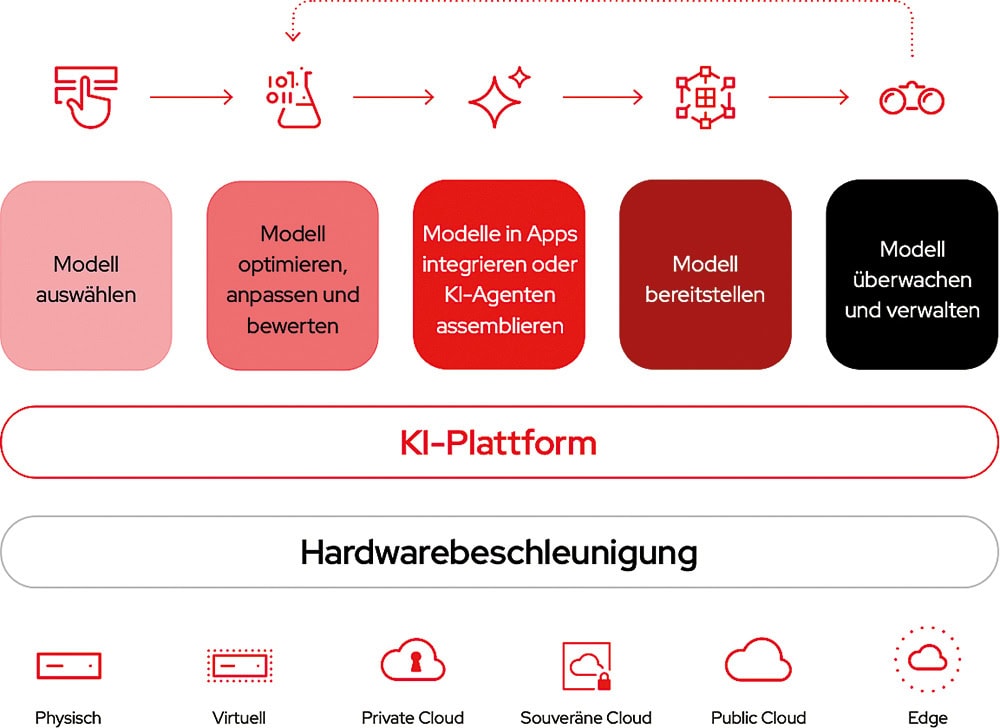
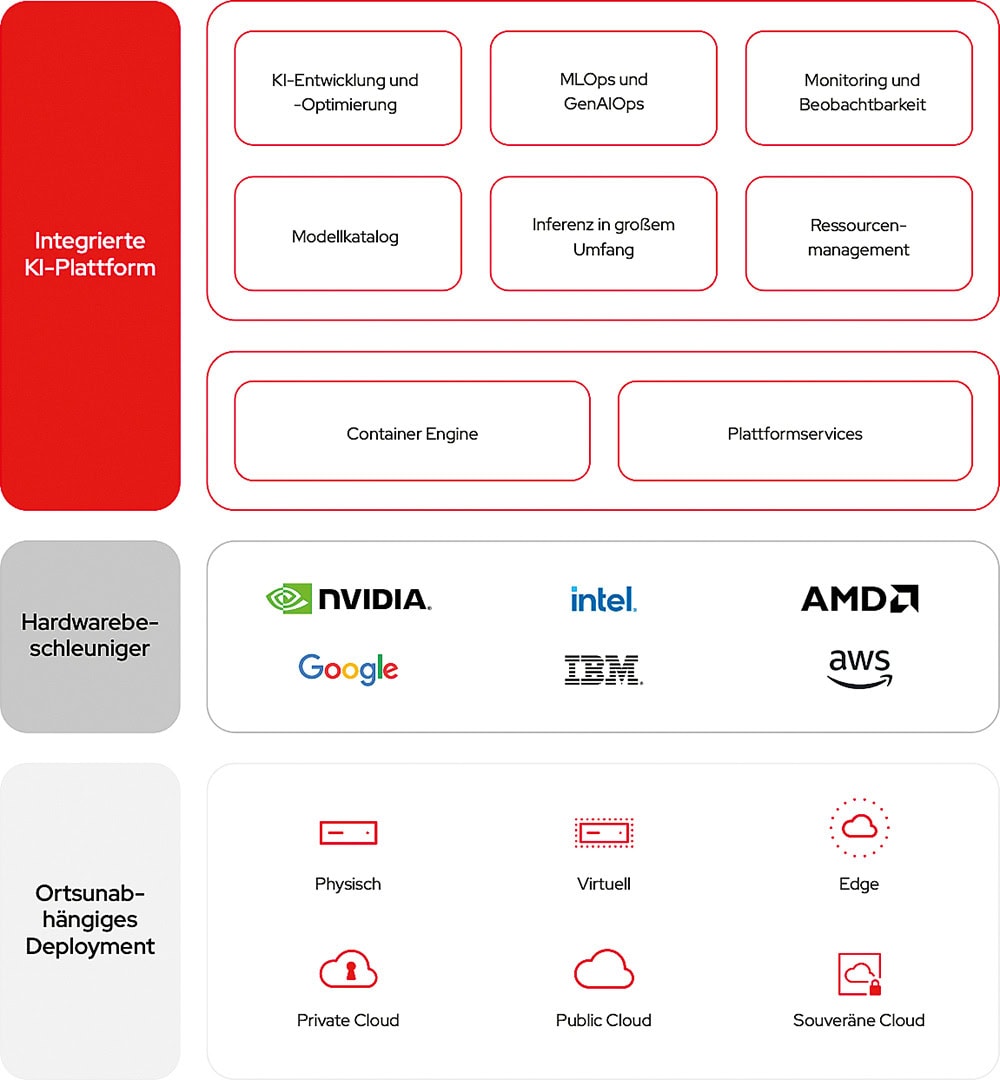
Lo ideal es que, para desarrollar una arquitectura de IA, las empresas apuesten, además de por los sistemas SAP, por una plataforma integrada que se conecte a la perfección con SAP y ofrezca todo lo necesario para gestionar de forma coherente los más diversos modelos de IA a lo largo de todo su ciclo de vida. Red Hat ofrece una plataforma de este tipo con Red Hat AI Enterprise. Se basa en Red Hat OpenShift, una plataforma de aplicaciones en la nube híbrida que permite la adaptación y el funcionamiento de modelos y aplicaciones en entornos híbridos, de modo que las empresas pueden utilizarla no solo para la integración de la IA en SAP en el marco del modelo «side-by-side», sino también para todas las cargas de trabajo de IA , independientemente de si se ejecutan en su propio centro de datos, en el borde o en la nube, o de si se trata de entornos físicos, virtualizados o en contenedores. Red Hat AI Enterprise es compatible con un amplio ecosistema de modelos de IA de código abierto y aceleradores de hardware, lo que permite a las empresas mantener su flexibilidad. El servidor de inferencia integrado se basa en el motor de inferencia de código abierto vLLM, que se escala a la perfección y combina un uso eficiente de la GPU con latencias bajas y estables, además de un despliegue abierto y portable. A esto se suman herramientas que automatizan la gestión de modelos y aplicaciones y fomentan los enfoques GenAIOps y MLOps. Detrás de todo ello se esconden prácticas que, al igual que DevOps en otras aplicaciones, permiten un desarrollo rápido, incremental e iterativo, y mejoran la colaboración entre científicos de datos, ingenieros de IA, desarrolladores y los distintos equipos de operaciones de TI.
El modelo «side-by-side» permite a las empresas ampliar sus sistemas SAP con funciones avanzadas de inteligencia artificial. Por ejemplo, los datos financieros pueden utilizarse para realizar cotejos basados en inteligencia artificial con las facturas, con el fin de detectar anomalías y prevenir intentos de fraude. La IA puede optimizar los niveles de existencias en función de las condiciones meteorológicas y los acontecimientos actuales y, si es necesario, realizar pedidos. Puede utilizar las descripciones de los puestos de trabajo de SAP para preseleccionar las solicitudes de empleo recibidas. O bien se encarga del análisis de las imágenes de las cámaras en la planta de producción para detectar defectos de fabricación y, a continuación, introduce los resultados en los sistemas SAP. Las posibilidades de aplicación son muy variadas y, en esencia, la imaginación apenas tiene límites.
Por supuesto, las empresas necesitan bastante experiencia para adaptar y gestionar la IA por sí mismas. Sin embargo, merece la pena invertir en ello, ya que garantiza la independencia: es posible adaptar o cambiar los modelos en cualquier momento, lo que puede resultar extremadamente valioso, sobre todo en el cambiante mundo de la IA. Además, los conocimientos sobre IA ayudarán en el futuro a implementar otros casos de uso y, a largo plazo, también pueden suponer un ahorro económico. Al fin y al cabo, en la nube suelen surgir costes sorprendentemente elevados, sobre todo cuando aumenta el número de usuarios o se incorporan nuevas aplicaciones de IA. Sin embargo, en esos casos, el camino de vuelta al centro de datos propio suele estar bloqueado, ya que para entonces ya se carece de las infraestructuras correspondientes y de los conocimientos necesarios.
Sin embargo, a la hora de desarrollar la experiencia necesaria y llevar a cabo los proyectos iniciales de IA, no hay que subestimar el valor de contar con socios experimentados. Estos aportan conocimientos a la empresa y evitan que se pierda el enfoque y que surjan proyectos interminables que nunca llegan a entrar en producción. En definitiva, el modelo «side-by-side» ofrece así una solución pragmática no solo para los retos actuales, sino también para los futuros de las empresas con entornos SAP clásicos.
Al directorio de socios:
 Deutsch
 English
 Español
 Français